Q/C Technologiesは2026年9月30日、米サンディア国立研究所の統合ナノテクノロジーセンター(CINT)との研究協力を発表した。
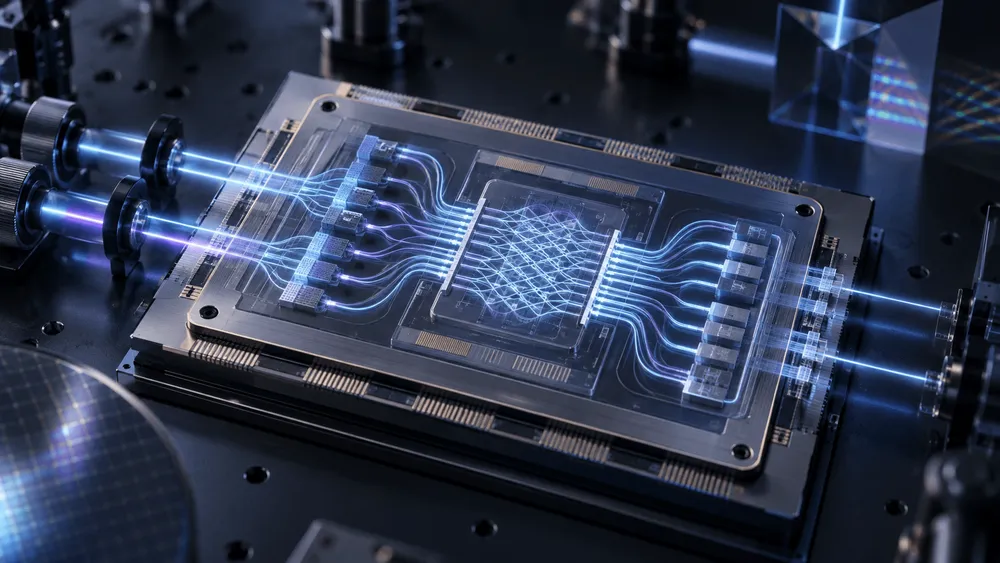
対象となるのは、学習済みAIモデルに新しい入力を処理させる「推論」向けの光処理ユニット(OPU)だ。光の干渉を計算に利用する同社の構想について、ナノフォトニクス部品や、それらを組み合わせたプロセッサーの構成を研究する。
ただし、今回発表されたのは研究計画であり、GPUを上回る処理速度や省電力性能を実証した測定結果は示されていない。
光を使った演算の原理を、実際にAI推論を担える装置へどう組み上げるかが、今回の共同研究の焦点となる。
今回は研究計画、GPUを上回る性能を実証したわけではない
Q/Cは2026年3月18日、独自OPUの設計と試作を目指す構想を発表していた。
当時示していたのは、専門技術者の確保、特許出願、基本的な計算機能の検証など、開発初期の取り組みだった。
今回の協力では、CINTとともに光演算やデバイス技術の候補を選定し、開発の優先順位や今後の方向性を検討する。OPUの実現に必要な部品やシステムの研究に、具体的な共同研究先が加わった形だ。3月の構想発表
Q/C Technologiesの9月30日の発表では、非線形演算、メモリ、計算精度、光損失、電子回路との統合などを研究課題として挙げている。
一方、評価に使ったAIモデル、推論速度、消費電力、GPUとの同一条件での比較結果などは示されていない。
発表で示された研究対象と、実際の性能を評価するために必要となる情報を整理すると次のようになる。
| 発表で示された研究対象 | 同発表では示されていない評価情報 |
|---|---|
| 非線形演算とメモリ | 採用する具体的な方式、動作させたAIモデル、評価データ |
| 計算精度 | 演算に使うビット数、推論結果の誤差や正答率 |
| 光損失 | 試作素子の測定条件、具体的な損失量 |
| 電子回路との統合 | 入出力を含めた推論速度、装置全体の消費電力、比較対象となるGPU |
この表は、9月30日の発表で公表された内容と、性能比較に必要な情報を整理したものだ。
発表に記載がないからといって、社内で試験が行われていないとまでは判断できない。
ただし、同じAIモデルを同じ条件で動かした比較結果がなければ、既存のGPUに対してOPUがどの程度の優位性を持つのかを評価することはできない。
今回公表されたのは企業のプレスリリースであり、この共同研究の成果を報告する査読済み論文やプレプリントは示されていない。
実機実験やシミュレーションの結果も公表されておらず、試作した素子の数や評価対象となるAIモデルの規模も分かっていない。
第三者による再現実験もまだなく、現時点では「光演算によってGPUよりどれだけ高速化・省電力化できるか」を定量的に評価できる段階ではない。
光で計算できても、それだけではAI推論装置にならない
Q/Cが目指しているのは、光同士を重ねたときに生じる「干渉」を計算に利用する方式だ。
光の波が互いに強め合ったり弱め合ったりする性質を利用し、AIで大量に使われる行列演算を光学的に処理する。
行列演算は、入力された数値に重みを掛け、その結果を足し合わせる処理を大量に繰り返すものと考えると分かりやすい。
Q/Cは3月の発表で、こうした計算の一部を光の伝搬そのものに担わせる構想を説明している。
ただし、光学回路の内部で演算が完了するまでの時間と、AIシステムが入力を受け取って最終的な回答を返すまでの時間は同じではない。
電子データを光信号へ変換し、光学回路で処理した後、再び電気信号として読み出すのであれば、その変換やデータ転送にかかる時間も含めて評価する必要がある。
こうした問題を考える手掛かりとなるのが、サンディアのPrasad P. Iyer氏らによる展望論文「Is Computing with Light All You Need?」だ。
査読誌『Advanced Intelligent Systems』に掲載され、オンライン版は2025年8月8日に公開された。DOIは10.1002/aisy.202500371である。
主に自由空間を光が伝わる方式を扱った論文であり、Q/CのOPUそのものを評価した研究ではない。Iyer氏らの論文
著者らは、材料、光学素子、装置構成、アルゴリズムまでを一体として最適化する必要があると論じている。
電子回路で動くニューラルネットワークの各処理を、そのまま光学部品へ置き換えればよいとは限らないためだ。
例えば、ニューラルネットワークでは各層の間に「非線形処理」が必要になる。
しかし、弱い光では材料に生じる非線形効果が小さい場合があり、光学的な層を単純に重ねるだけでは、電子回路で構成されたニューラルネットワークと同じ処理を再現できるとは限らない。
光を検出して電気信号へ変換する部分の特性も、計算結果や性能に影響する。
Q/Cが今回、非線形演算だけでなく、メモリや電子回路との統合まで研究対象に含めたのは、個々の光学演算を実現するだけでなく、実際に使える推論装置へ発展させるためとみられる。
ただし、具体的にどの材料や回路方式を採用するかは発表されていない。
そのため、Iyer氏らの論文で紹介された構成をQ/Cがそのまま採用すると考えることもできない。
最高技術責任者のYossef Ehrlichman氏も、今回の共同研究について、完成した製品ではなく今後の開発に向けた取り組みとして説明している。
「CINTとの取り組みによって、光の基本的な機能から統合されたOPU構成へ至る道筋を定められると考えている」
これはQ/Cが共同研究に期待する成果を示したものであり、OPUがすでに完成したという意味ではない。
CINTとの協力で何ができるのか
CINTは、サンディア国立研究所とロスアラモス国立研究所が共同運営する、米エネルギー省(DOE)のナノテクノロジー研究施設だ。
DOEによるCINTの説明によると、ナノスケールで作製した材料や構造を、より大きな装置やシステムへ組み込むための研究を行っている。
光をナノスケールで制御する研究に加え、材料の作製や評価、理論計算、シミュレーションなどを組み合わせられることが特徴だ。
光演算の原理が成立しても、実際に必要な部品を製造できるか、それらを他の光学部品や電子回路と接続できるかを確認しなければ、プロセッサーとしての設計は固まらない。
Q/Cが今回発表したナノフォトニクス部品の共同研究は、こうしたCINTの研究領域と重なる。
重要なのは、サンディア国立研究所という名前そのものではなく、OPUに必要な部品をどのような条件で試作・評価し、装置全体へ統合できるかだ。
CINTの利用制度にも、研究施設としての条件がある。
CINTの公式案内によると、成果を公開する研究では、成果の公開を条件として施設や装置を無償で利用できる仕組みがある。
一方、成果を非公開にする専有研究では、施設利用にかかる費用を利用者側が負担する。
また、公開研究の場合でも、利用者自身が行う研究に必要な人件費や旅費などをCINTが負担するわけではない。
ただし、Q/Cの今回の発表では、どの利用制度を適用するのか、料金や成果公開についてどのような契約を結んだのかまでは説明されていない。
CINTの一般的な利用条件を、そのままQ/Cとの共同研究に当てはめることはできない。
研究施設を利用できること、試作デバイスを作れること、完成したプロセッサーで高い性能を実証できることは、それぞれ別の段階だ。
次に必要なのは、GPUと条件をそろえたAI推論の比較
Q/Cが部品研究から実用化へ進むうえで重要になるのは、どのAIモデルを、どの計算精度で、どの程度の速度と消費電力で動かせたのかという具体的な測定結果だ。
例えば「推論速度」が公表されても、光学演算部分だけを測った値なのか、電子信号から光への変換、データ転送、結果の読み出しまで含めた値なのかによって意味は大きく変わる。
消費電力についても、同じ範囲を測定しなければGPUなど既存の電子プロセッサーと公平に比較することはできない。
速度や消費電力だけでなく、AIが出す結果の精度も合わせて見る必要がある。
光演算では、計算精度を下げることで高速化や省電力化を実現できても、その結果としてAIモデルの精度が大きく低下するのであれば、用途によっては利点が小さくなる。
同じAIモデルと評価データを使い、同じ条件でGPUなどと比較し、処理速度、消費電力、推論精度を示す。
さらに第三者が再現できる測定条件が公開されれば、光演算によってAI推論のどの部分をどれだけ高速化・省電力化できるのかを、より具体的に判断できるようになる。