


オランダの半導体企業Axelera AIは2026年11月12日、大規模AI推論向けの第3世代アーキテクチャ「Titania」の詳細を発表した。複数の半導体を組み合わせるチップレット方式を採用し、1TBのアクセラレータメモリを搭載する4U空冷参照サーバー「AX8」も公開している。量産開始は2027年第3四半期を予定しており、既存データセンターの電力・冷却設備を活用しながら、大規模な対話型AIを運用できるようにする狙いだ。実用化に向けては、大規模モデルを格納できるメモリ容量に加え、実際の利用環境で十分な応答速度を確保できるかが重要になる。
128GBのチップパッケージを8基搭載、1TBの空冷サーバーを構成
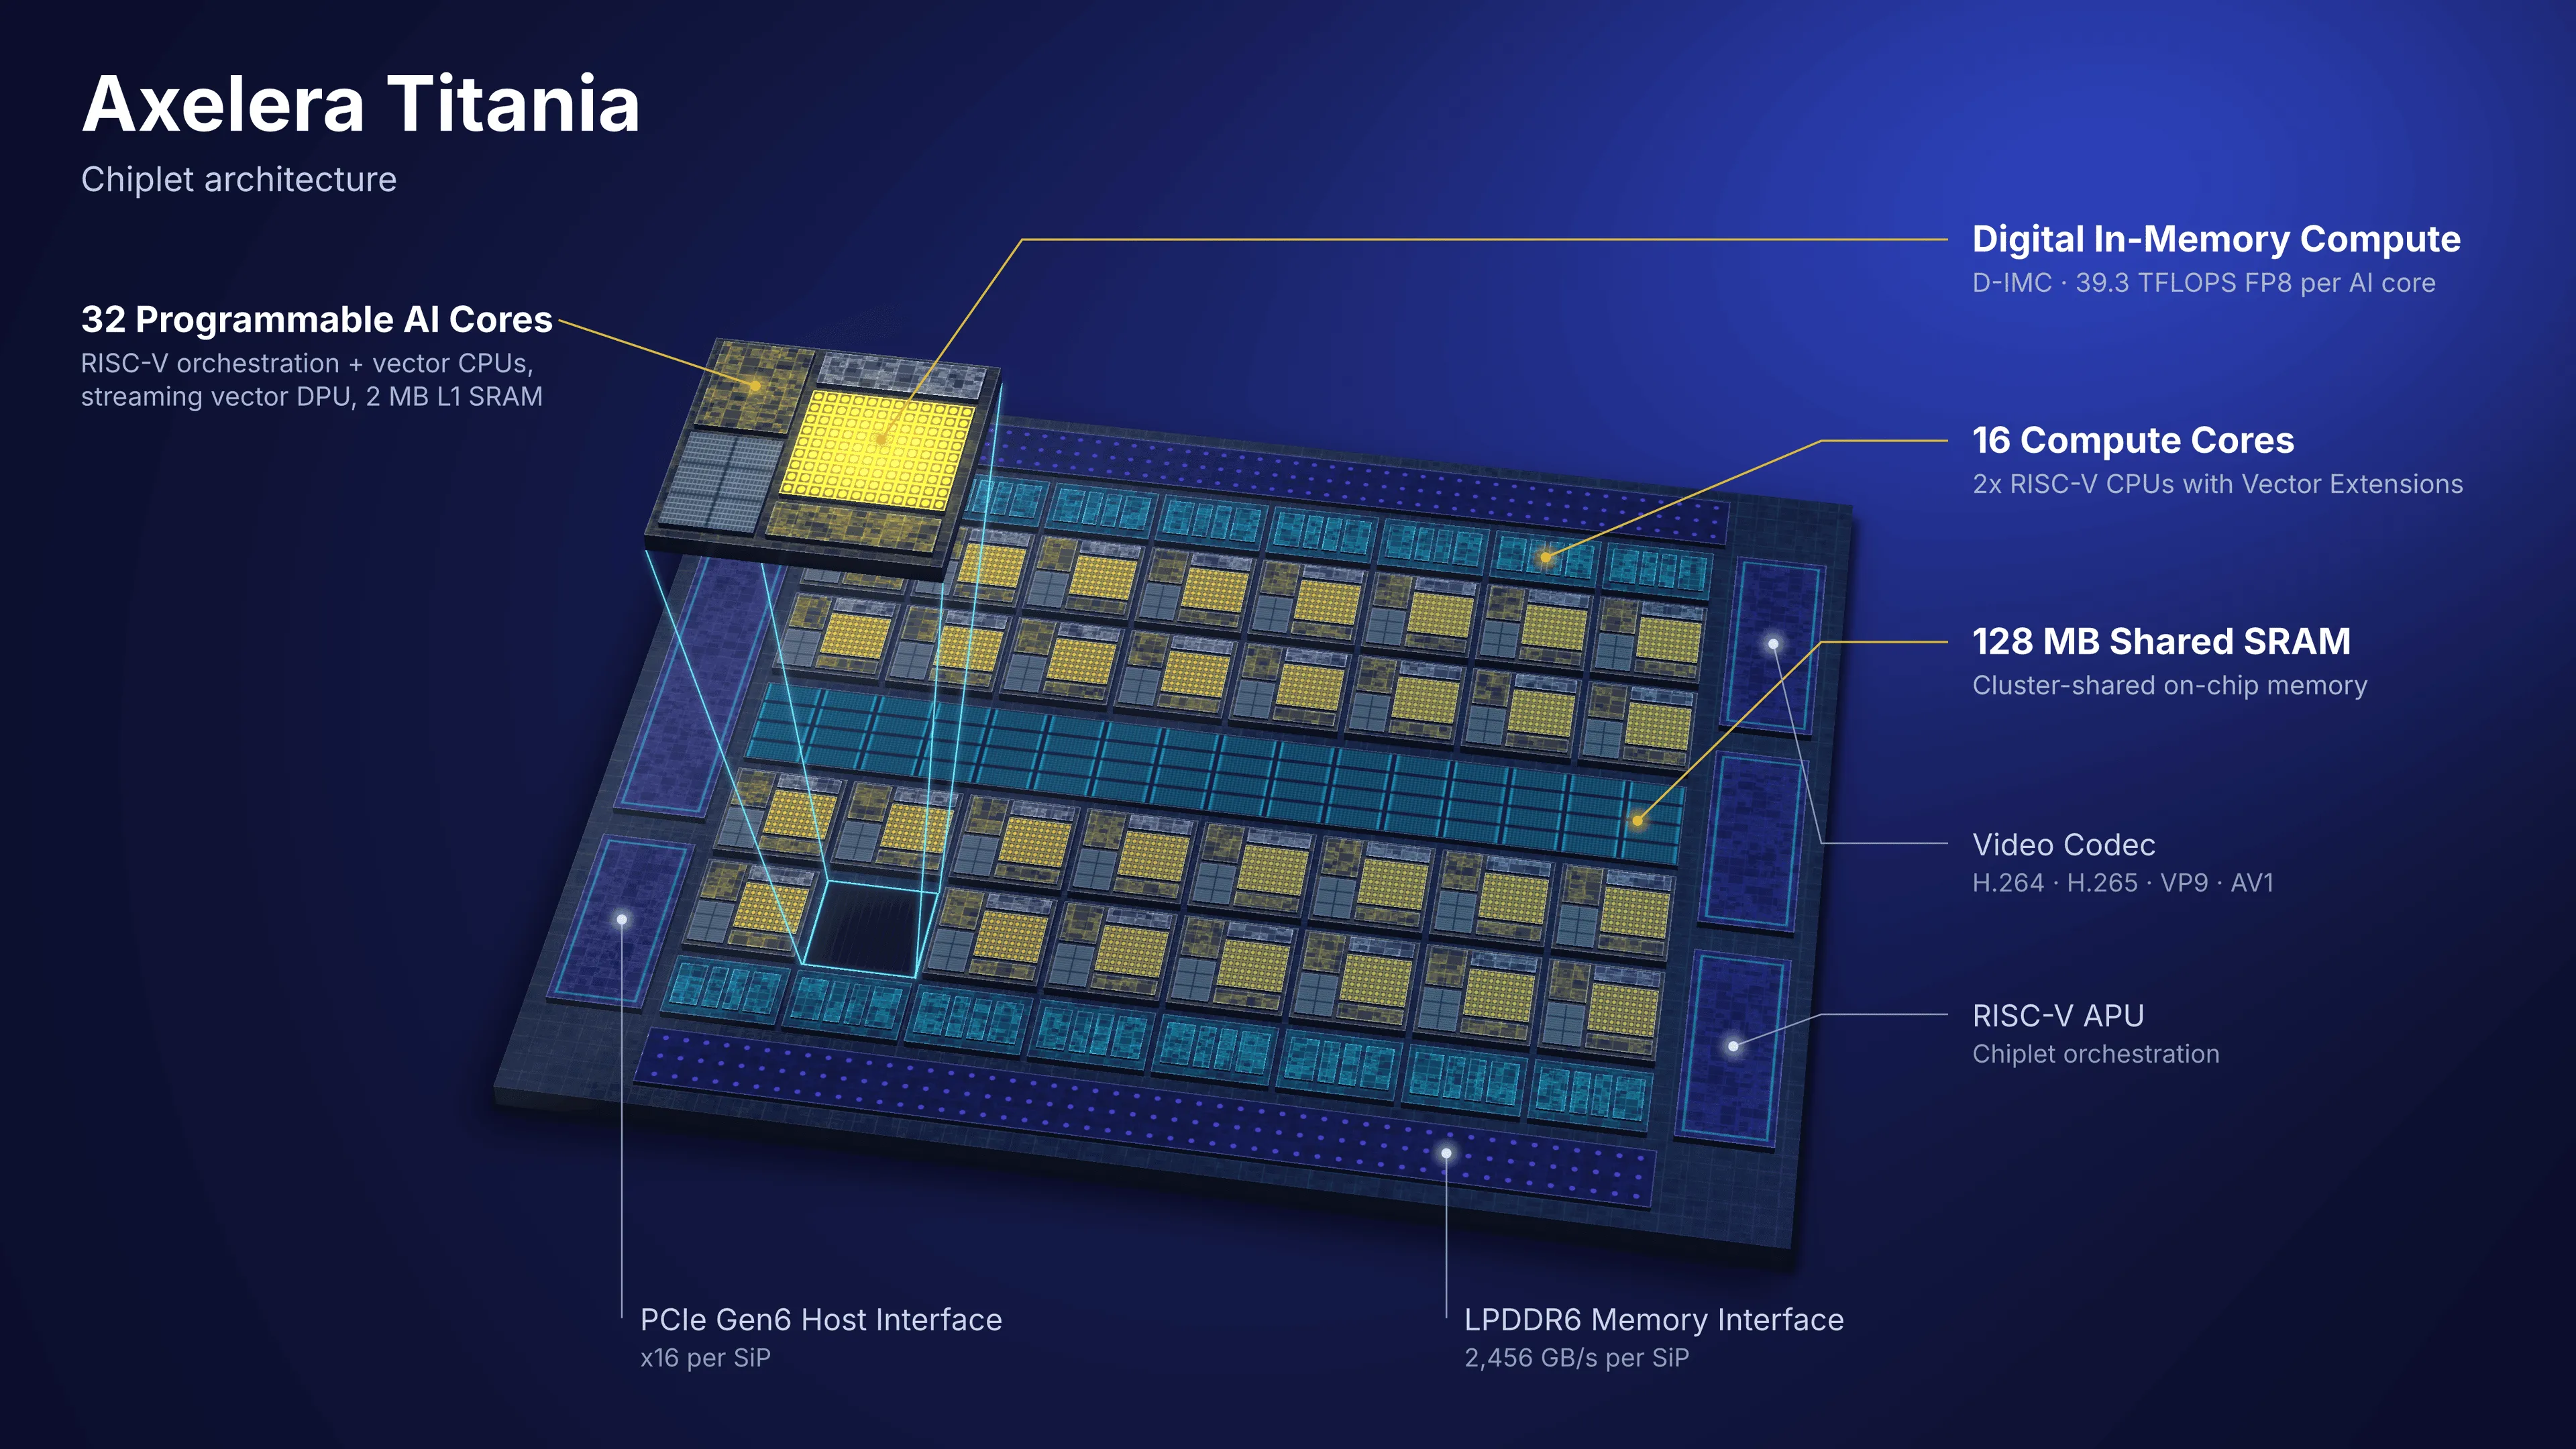
Titaniaは、2個のチップレットと128GBのLPDDR6メモリを一つのパッケージにまとめた構成を採用する。このパッケージはSiP(System in Package)と呼ばれ、AX8には8基のSiPが搭載される。サーバー全体では1TBのアクセラレータメモリを備え、FP8演算性能は20PFLOPS、合計メモリ帯域は19.6TB/sに達する設計だ。
Axelera AIは、AX8を標準的な4Uサイズの空冷サーバーとして設計し、典型的な消費電力を5〜6kWと見込んでいる。ラック構成としては、15kWのラックにAX8を2台、30kWの空冷ラックに5台収容する想定だ。今回公表された主な仕様を以下にまとめた。
| 対象 | 構成・容量 | 電力・設置条件 |
|---|---|---|
| SiP | チップレット2個、LPDDR6メモリ128GB | AX8に8基搭載 |
| AX8参照サーバー | アクセラレータメモリ1TB、FP8演算性能20PFLOPS、合計メモリ帯域19.6TB/s | 標準4U、空冷、典型消費電力5〜6kW |
| ラック構成 | AX8を2台または5台 | 15kWラックに2台、30kW空冷ラックに5台 |
※Axelera AIが2026年11月12日に発表した設計値と想定構成。メモリ帯域19.6TB/sと演算性能20PFLOPSはAX8全体の数値。
今回の発表で注目されるのは、1TBという大容量メモリを備えたAI推論サーバーについて、消費電力とラックへの搭載条件まで具体的に示した点だ。大規模モデルを実行できるだけでなく、既存のデータセンターに設置できるかを検討するための材料がそろいつつある。
中国メディアのIT之家は、Titaniaの設計電力が400W、FP8演算性能が2.5PFLOPSと報じている。また、128MBの共有SRAMと32個のRISC-Vコアを備えるという。ただし、これらはTitaniaの半導体に関する報道値であり、AX8全体の消費電力5〜6kWや演算性能20PFLOPSとは対象が異なる。実際の導入台数を検討する際には、半導体単体ではなく、サーバー全体の電力とラックの収容条件を基準にする必要がある。
提供形態としては、PCIeカードに加え、OCP(Open Compute Project)に準拠したUBBベースボードに8基のOAMモジュールを搭載する構成も予定されている。OEMパートナーを通じて、空冷と液冷の両方に対応した推論サーバーを提供する方針だ。空冷4Uという構成は既存設備を活用しやすい選択肢となるが、実際に設備更新をどこまで抑えられるかは、導入先の電力供給能力や冷却設備によって異なる。
LPDDR6を採用し、1兆6000億パラメータのAIモデルに対応
Axelera AIによると、AX8はFP4精度で1兆6000億パラメータのAIモデルを1台に格納し、KVキャッシュを保持するためのメモリ容量も確保できるという。こうした大規模モデルへの対応で重視しているのが、MoE(Mixture of Experts:混合専門家)アーキテクチャだ。
MoEは、複数の専門家に相当する処理単位を用意し、入力に応じて一部だけを選択して計算する仕組みである。モデル全体のパラメータ数が非常に大きくても、各トークンの処理で使用するパラメータはその一部に限られる。特に疎なMoEモデルでは、大量の重みをメモリに保持しながら、必要な部分だけを効率よく読み出すことが重要になる。そのためAxelera AIは、メモリ帯域のピーク性能だけでなく、大容量メモリの確保と帯域の利用効率を重視した設計を採用している。
メモリには、高帯域幅メモリ(HBM)ではなくLPDDR6を選択した。同社によると、メモリの消費電力を抑えるとともに、HBMの供給や高度なパッケージング技術への依存を減らす狙いがある。また、演算アーキテクチャには、メモリ内で計算を行うデジタル・インメモリ・コンピューティングを採用し、浮動小数点演算への対応も追加した。小型の演算コアを多数配置し、データ転送を最適化することで、大規模モデルの重みを保持しながら効率よく推論を実行する設計だ。
では、1TBのメモリに1兆6000億パラメータのモデルを格納する場合、実際にどの程度の容量が必要になるのだろうか。すべての重みを4ビットで保存すると仮定すれば、必要な容量は単純計算で求められる。
つまり、1兆6000億パラメータの重みをすべて4ビットで保存した場合、必要な容量は約800GBとなる。これは当編集部による単純計算であり、量子化スケールなどの付加情報やKVキャッシュ、モデル実行に必要な作業領域は含んでいない。
したがって、公称1TBのメモリから重みの800GBを差し引いた約200GBを、そのままKVキャッシュなどに利用できるわけではない。実際に必要なメモリ容量は、モデルの構造、量子化方式、入力の文脈長、同時に処理する利用者数などによって変化する。特に長い文脈を扱う場合や、多数の利用者に同時応答する場合には、KVキャッシュの容量が重要になる。1TBという仕様は大規模モデルを格納できる可能性を示しているが、それだけで実際の応答速度や推論精度まで保証されるものではない。
Europaからの移行を支援、2028年初めまでの顧客導入を計画
Axelera AIは、Titaniaの導入にあたり、既存製品とのソフトウェア互換性も重視している。同社はMetis、Europa、Titaniaの3世代で、開発環境の「Voyager SDK」と「AxeleraScript」を共通して使用する方針を示した。さらに、Europaを4チップ搭載した「Axelera Server 250p」と置き換えられるTitaniaのPCIeカードも設計している。これにより、Europa向けに開発されたモデルを、2028年には再移植せずにTitaniaへ移行できるようにする計画だ。
大規模モデルの実行機能も拡充する。Titaniaでは、テンソル並列、エキスパート並列、パイプライン並列という3種類の並列処理方式への対応を予定している。テンソル並列は演算を複数の処理装置に分散し、エキスパート並列はMoEモデルの専門家部分を分担する方式だ。一方、パイプライン並列ではモデルの処理段階を複数の装置に割り当てる。これらを組み合わせることで、大規模モデルを複数のアクセラレータに分散して実行することを目指す。
さらに、投機的デコード、KVキャッシュのオフロード、処理の分離といった推論最適化機能にも対応する予定だ。投機的デコードは、生成するトークンを先読みして検証することで、出力を高速化する技術である。KVキャッシュのオフロードは、キャッシュの一部を別のメモリ領域などに移し、アクセラレータ側のメモリ使用量を調整する仕組みだ。こうした機能によって、モデルの規模や利用状況に応じた柔軟な推論処理を可能にする方針である。
言語モデル以外への対応も計画されている。Titaniaは、H.265とAV1による8K映像のデコード、4K映像のエンコードをチップ上で処理する機能を備える予定だ。これにより、言語・音声・画像を扱うマルチモーダルAIとライブ映像の処理を、同じシステム内で実行する構想を描いている。大規模な言語モデルの推論だけでなく、映像を含むリアルタイムAI処理への展開も視野に入れている。
Titaniaの開発計画は、当初の発表から具体化が進んでいる。2025年3月6日の公式発表では2028年の導入を目標としていたが、今回の発表では2027年第3四半期に量産を開始し、2028年初めまでに顧客への導入を進める計画が示された。また、Axelera AIによると、顧客からの導入確約は総額3億ドルを超えている。ただし、これらの契約条件や売上計上の時期については明らかにされていない。
電力効率は最大7倍、TCOは最大20倍改善との予測
Axelera AIはTitaniaについて、最先端のデータセンター向けサーバーと比較して、電力当たりの処理量を最大7倍、総保有コスト(TCO)を最大20倍改善できると予測している。TCOには、ハードウェアの購入費用だけでなく、運用に必要な電力や冷却、保守などの費用も関係する。
ただし、今回の発表では、これらの予測に使用した比較対象の機種や具体的なAIモデル、処理条件、同時利用者数などが示されていない。TCOの算出に使用した費用の内訳も公表されておらず、実際の導入によってどの程度のコスト削減が得られるかは判断できない。また、製品価格、OEM製品の確定納期、第三者による推論性能の検証結果も明らかになっていない。最大7倍、最大20倍という数値は、現段階では同社の予測であり、実測によって確認された性能ではない。
Axelera AIのCTOであるEvangelos Eleftheriou氏は、すでに出荷されているEuropaについて、メモリ帯域の88%をトークン生成に利用できていると説明した。これはメモリ帯域を効率よく活用する同社の設計思想を示す数値だが、Europaのシリコンに関する説明であり、Titaniaの実測結果ではない。Titaniaで同様の帯域利用効率を達成できるか、さらにそれが実際の応答速度や処理能力にどの程度寄与するかは、今後の検証を待つ必要がある。
同社は、11月15日から19日まで米シカゴで開催されるスーパーコンピューティング関連イベント「SC26」で、Titaniaの詳細な技術解説を予定している。実際の導入を検討する企業にとっては、同じAIモデル、文脈長、同時利用者数という条件で推論性能を比較することが重要だ。特に、応答開始までの待ち時間やトークン生成速度、サーバー全体の消費電力、導入・運用費用を総合的に評価する必要がある。
Titaniaの特徴は、大規模AIモデルに必要なメモリ容量を確保しながら、標準的な空冷サーバーとして運用できる設計にある。公表された仕様どおりの性能を実機で発揮し、実用的な応答速度とコスト効率を両立できれば、既存データセンターで大規模AI推論を運用するための新たな選択肢となるだろう。


