


AMDのJiakun Yan氏ら6人の研究チームが、GPUからCPUに通信制御を任せる新技術「KIWI」を開発した。AIモデル「GLM-5.3」の生成処理に応用した「KIWI-EP」では、従来の通信方式「MORI-EP」と比較して、出力1トークンあたりの処理時間を約55ミリ秒から約39ミリ秒に短縮した。これは入力処理と生成処理にそれぞれ8ノードを割り当て、GPUあたりの同時実行数を1に設定した場合の結果で、論文の図8から読み取った概数である。
研究チームは2026年11月18日、設計と実機試験の結果をarXivにプレプリントとして公開した(arXiv:2611.23848v1、DOI: 10.48550/arXiv.2611.23848)。KIWIの特徴は、GPUが通信を開始しながら、ネットワークカード(NIC)への指示をCPUに任せる点にある。データ本体はNICがGPUメモリ間で直接転送するため、CPUを経由しない。また、CPUに任せる処理をアプリケーション側で自由に定義できる仕組みを備えており、KIWI-EPはこれを複数の専門家ネットワークを使う言語モデルに応用したものだ。
GPUがCPUに任せるのは通信制御
GPU間通信では、GPU自身が転送を開始することで、計算処理を中断してCPUの指示を待つ必要がなくなる。現在広く使われているGPUからNICを直接操作する方式「GPUDirect Async(GDA)」では、GPUが転送先や通信命令を準備し、NICに送信開始を通知するところまで担当する。しかし、こうした通信制御には、命令を決められた順序で実行する逐次処理が多く含まれる。大量の並列計算を得意とするGPUよりも、CPUコアに任せた方が効率的ではないかと研究チームは考えた。
KIWIが採用したのは、「逆オフロード(Reverse Offload)」と呼ばれる方式だ。通信を開始するのは従来と同じくGPUだが、GPUから依頼を受けたCPU上の代理スレッドがNICへの指示を担当する。論文の図1が示すように、GDAと逆オフロードのどちらでも、データ本体はNICによってGPUメモリ間で直接転送される。異なるのは、転送命令を組み立ててNICに渡す処理をGPUとCPUのどちらが担当するかという点だ。
KIWIでは、アプリケーションがCPUで実行したい関数をあらかじめ登録しておく。AMDのGPUでは、同じ命令を同時に実行するスレッドの集まりを「ウェーブ(Wave)」と呼ぶが、KIWIはウェーブごとに専用の待ち行列(キュー)を設けている。GPUはキューに関数の識別子と引数を書き込むだけで次の処理に進み、CPU側の代理スレッドが依頼を取り出して登録済みの関数を実行する。複数のウェーブが同じキューを取り合わずに済むため、依頼が集中した際の競合を抑えられる。
研究チームは、この受け渡しにかかる時間も測定した。Instinct MI300Xを1基使い、他の依頼がない状態でGPUからCPUへ依頼を送り、GPUに応答が戻るまでの往復時間を測ったところ、中央値は1.92マイクロ秒だった。これはメモリへの単純な書き込みを使った基準実装と同じ値で、KIWIのキューによる追加の遅延は測定上ほぼ生じていない。
論文の表IIIでは、GPUがキューに依頼を書き込む時間も比較している。KIWIのキュー単体では、1ウェーブでも1,024ウェーブでも登録時間は0.12マイクロ秒だった。CPUで登録済みの関数を呼び出す構成でも、1,024ウェーブでのGPU側の登録時間は0.16マイクロ秒にとどまった。ただし、これらはGPUとCPUの間で依頼を受け渡す時間であり、別のノードへのデータ転送には、NICへの指示やネットワーク通信にかかる時間が加わる。
トークン数によって通信方式の優劣が逆転
KIWI-EPが対象とするのは、複数の専門家ネットワークを使い分ける「Mixture of Experts(MoE)」モデルの通信処理だ。MoEでは、入力された各トークンを担当する専門家が配置されたGPUに送り、計算結果を回収して統合する必要がある。このとき、多数のGPU間で小さなデータを頻繁にやり取りするため、通信の遅延が推論性能に影響する。KIWI-EPでは、複数の宛先への送信を一つの依頼にまとめ、受信件数の通知や同期処理もCPU側の関数として実行できるようにした。GPUには、送信先に応じたデータの詰め替えや、受信データの展開といった処理が残る。
ただし、GPUからCPUに依頼を渡すだけでは、代理スレッド間で負荷が偏る可能性がある。例えば、16ウェーブからなる各グループの先頭ウェーブだけが依頼を出す場合、使われるキューは0番、16番、32番と一定間隔になる。これらを4本の代理スレッドに単純な順送りで割り当てると、すべての依頼が同じスレッドに集中してしまう。そこでKIWI-EPは、グループごとに担当スレッドをずらす割り当て方式を採用し、実際に依頼を出すキューの範囲も管理することで負荷を分散している。
通信性能の比較試験には、DeepSeek-V3と同じMoE層の構成を採用した。隠れ層の幅は7,168、専門家の数は256で、各トークンに対して8個の専門家を選択する。データ形式はBF16に統一し、各通信方式に同一の入力を与えた。測定対象はトークンの配布と計算結果の回収にかかる合計時間で、参加プロセスのうち最も遅かったものの値を採用している。
2ノード構成でGPUあたり1トークンを処理した場合、論文の図7から読み取れる通信時間は、比較対象の中で最速だったMORI-EPが約111マイクロ秒、KIWI-EPが約49マイクロ秒だった。KIWI-EPは通信時間を半分以下に抑えている。しかし、同じ2ノード構成でもGPUあたり64トークンになると、MORI-EPが約174マイクロ秒、KIWI-EPが約274マイクロ秒となり、性能が逆転した。
KIWI-EPが比較対象の中で最速だったのは、2ノード構成ではGPUあたり16トークンまで、4ノード構成では32トークンまでだった。一方、8ノード構成では、試験した1〜64トークンのすべての条件でKIWI-EPが最も短い通信時間を記録した。
研究チームは、この性能差をノード間でのデータ転送方式の違いによるものと分析している。KIWI-EPは送信先のGPUごとにデータを転送するのに対し、MORI-EPはまず宛先ノードにデータを送り、そのノード内で各GPUに配布する。トークン数が増えてネットワーク帯域の制約が強まると、ノード間の転送回数を抑えられるMORI-EPが有利になるという。KIWI-EPの優位性は、処理するトークン数とノード構成によって変化することが分かった。
GLM-5.3の生成時間を最大29%短縮
研究チームは通信部分だけでなく、実際の大規模言語モデルを動かした場合の性能も評価した。使用したのは8ビット浮動小数点形式(FP8)のGLM-5.3で、推論エンジンにはvLLMを採用した。入力は8Kトークン、出力は1Kトークンに設定し、入力をまとめて処理する「Prefill」と、トークンを一つずつ生成する「Decode」を別々のノードで実行した。Prefillには従来のMORI-EPを使い続け、Decode側だけをMORI-EPとKIWI-EPで切り替えて比較している。各測定点には、少なくとも3回実行した結果の中央値を採用した。
評価したのは、PrefillとDecodeにそれぞれ2ノード、4ノード、8ノードを割り当てる3種類の構成だ。最大の「8P8D」構成では、合計16ノードを使用する。各ノードにはAMD Instinct MI300Xが8基、56コアのIntel Xeon Platinum 8480+が2基、400Gb/s対応のNVIDIA ConnectX-7が8基搭載されている。各GPUと対応するNICは同じPCIeスイッチに接続され、CPU側の代理スレッドも対応するGPUに近いNUMA領域のCPUコアに固定した。
論文の図8では、試験したすべての構成と同時実行数において、KIWI-EPの出力1トークンあたりの処理時間(Time Per Output Token:TPOT)がMORI-EPを下回った。最大の改善率は29%だった。8P8D構成でGPUあたりの同時実行数を1に設定した場合、図から読み取れる値はMORI-EPが約55ミリ秒、KIWI-EPが約39ミリ秒となる。同じ8P8D構成で同時実行数を128に増やした場合でも、約62.8ミリ秒から約51.0ミリ秒に短縮された。
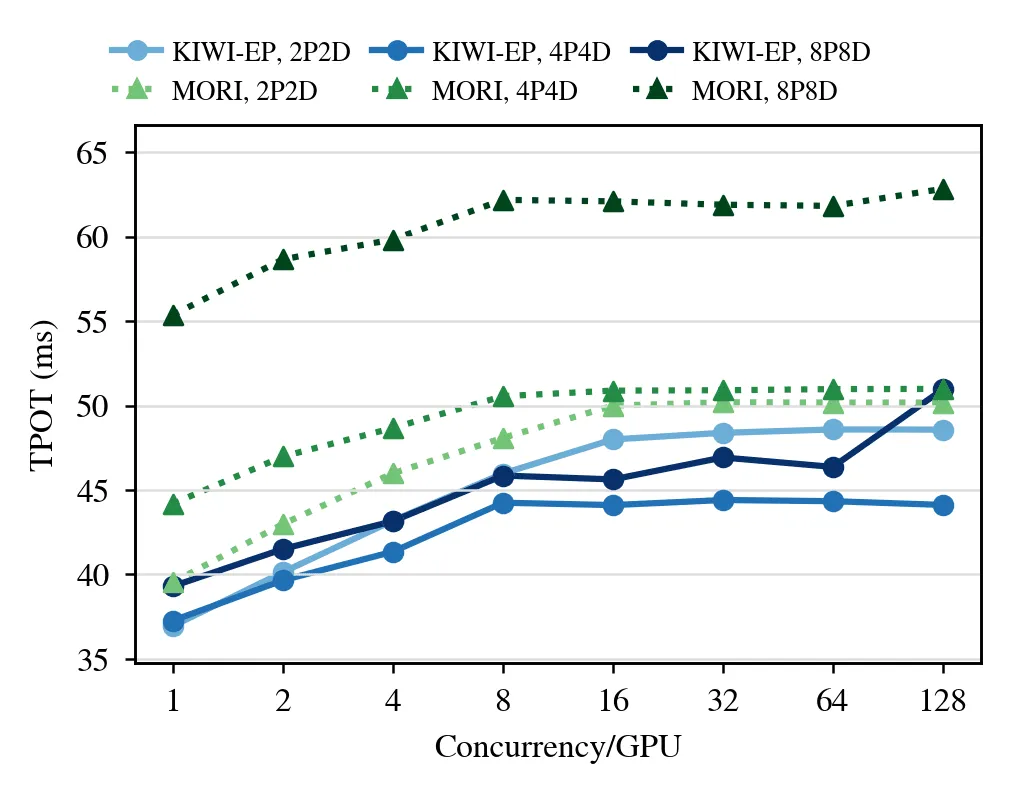
なお、vLLMでは処理中の要求が順次入れ替わるため、実際にDecodeを実行している要求数は設定された同時実行数より少なくなる。このため、通信部分の性能改善率が、そのままモデル全体の生成時間の短縮率になるわけではない。
今回の性能改善には、CPUへの通信制御の移行だけでなく、複数の宛先への送信をまとめる仕組みや、代理スレッドの負荷分散も寄与している。研究チームは8ノード構成の通信試験で、これらの変更を段階的に追加して効果を調べた。一方、GLM-5.3で測定した最大29%という改善率は、生成側の通信方式全体をMORI-EPからKIWI-EPへ切り替えた結果である。
研究チームは、KIWIのソースコードとベンチマーク用スクリプトをGitHubで公開している。今回の性能評価はMI300Xクラスタを使った著者ら自身の実測であり、独立した追試は確認できていない。また、評価に使ったKIWI-EPはGPU 1基につき4個のCPUコアを代理スレッドに割り当てている。別の推論環境への導入を検討する際には、CPUコアの追加負荷に加え、実際のトークン数や同時実行数に応じて、どの程度の生成時間短縮が得られるかが判断材料となる。


