セキュリティ企業Hacktron AIは、AnthropicのClaudeを使ってOpenAIの社員アカウントを乗っ取り、社内コードの保管先まで到達したと公表した。2026年9月13日の技術報告によると、7月に実施した検証は最初の発見から72時間未満で進み、社員のCodexを通じて内部リポジトリに無害な変更提案を作成するに至ったという。OpenAI側の問題は修正済みとされている。入口となった画像処理の欠陥から、共通認証を経由して開発環境まで進めた経路には、AIが攻撃コードを書く速さと、サービス同士の権限をどう切り離すかという問題が重なる。
画像から社内コードへ、越えた認証の境界
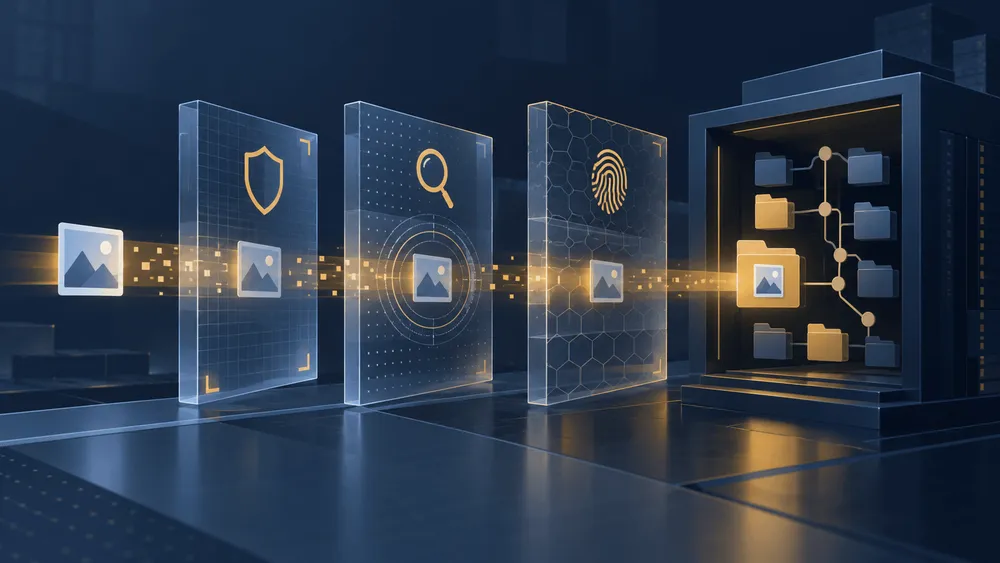
侵入の出発点は、OpenAIのコミュニティフォーラムにある画像アップロード機能だった。フォーラムは外部のソフトウェアであるDiscourseを使い、画像のチェックにはFastImageというライブラリを利用している。FastImageが対応していないHEIF形式は別の処理へ回され、その先でImageMagickと画像処理ライブラリlibheifが働く構成だ。
Hacktronによると、このlibheifに、確保したメモリの境界を越えて書き込む「ヒープバッファオーバーフロー」が残っていた。細工した画像を処理させると、本来の画像変換とは別のコードをサーバー上で実行できる。入口は投稿画像でも、届く先は処理を担うサーバーの権限そのものだ。
さらにOpenAIのシングルサインオン(SSO)に問題があり、フォーラムへの侵入から、そこでOpenAIログインを使っていた利用者のChatGPTやCodexのアカウントへ進めたという。SSOは共通の認証で複数サービスを利用できる仕組みだ。Hacktronは、フォーラムから他製品へアクセスが広がる部分はOpenAI側の問題であり、Discourse固有の欠陥ではないと説明している。
研究チームは複数の社員アカウントを乗っ取り、そのうちCodexがOpenAIのGitHub組織に接続されているアカウントで到達を実証した。Codexに指示し、社内リポジトリ「openai/openai」に無害なプルリクエストを作成したという。プルリクエストはコード変更の提案を意味し、採用や本番環境への反映までを示すものではない。
研究者らは内部コードや機微情報を閲覧せず、実証後に検証を停止したと述べている。GitHub以外にもSlackやメールなどへ影響が及ぶ可能性を挙げているが、それらから実際に情報を取得したとの報告とは区別する必要がある。ChatGPTの全利用者に無条件でアクセスできた、という話でもない。報告が問題視しているのは、フォーラムのOpenAIログインと、その先につながるアカウントの権限だ。
Claudeが縮めた攻撃コードの開発時間
Hacktronが7月23日に調べ始めた画像処理の欠陥は、修正方法すら知られていない問題ではなかった。同社によれば、問題のコードは前年に上流の開発元で変更されていたものの、セキュリティ修正と明記されず、脆弱性の識別番号であるCVEも付かなかった。Discourseで使われていたパッケージには修正が届いておらず、同社はこの扱いが旧版への修正適用を遅らせた可能性を指摘している。
Claudeが担ったのは、その欠陥を動作する攻撃コードに変える作業だった。最初に使ったOpus 4.8は、メモリ配置を予測しにくくする防御機構ASLRを無効にすると動くコードを作れたが、有効にした環境では複数回試しても安定した実装に至らなかったという。脆弱性を見つけることと、実際の稼働条件で利用できることの間には、なお距離があった。
そこで研究者らは、7月24日夜にOpus 5へ切り替えた。同社の説明では、ローカルのMac向けに動くコードが3時間以内にでき、その後Discourseのサーバー環境へ移植を進めたという。自分たちのテスト環境でClaudeに試行を繰り返させ、生成されたコードをOpenAIのフォーラムでも利用した。
Hacktronは一連の所要時間を次のように記している。
「最初の発見からOpenAIのリポジトリへのアクセスまで、全工程は72時間未満だった」
ただし、これは熟練した研究者が誘導した一事例の結果である。Hacktron自身も完全自律の侵入ではなかったと明記しており、モデルを使えば誰でも同じ結果を出せると証明したわけではない。モデルの交代前後で結果が変わったという観察と、製品全般の攻撃能力を測る比較試験は分けて読むべきだ。
費用にも対象の違いがある。公表された3,000ドル未満という数字は、3人の研究者が2カ月にわたり複数社を調べた「HEIF Heist」全体のトークン費用を指す。OpenAIへの侵入だけの費用でも、人件費を含む総額でもない。それでも、攻撃コードの作成や環境への適応にAIを使い、小さなチームが検証を進めた点は、守る側が想定する攻撃の準備期間に関わってくる。
画像処理の修正だけでは閉じない経路
Discourseは7月28日の公式告知で、画像アップロードを通じたリモートコード実行の問題をCVE-2026-32882として説明し、修正版libheifを含むDockerイメージへの更新を案内した。更新には稼働環境の再構築が伴う。対応するカーネルを使う最新サポート版には、画像処理を隔離する追加のサンドボックスも導入された。
Hacktronの侵入経路とDiscourseの修正内容を対応させると、運用側が点検すべき場所を分けて考えられる。
| 攻撃が進んだ段階 | 報告・告知で確認できる内容 | 運用上の確認点 |
|---|---|---|
| 投稿画像からフォーラムのサーバーへ | libheifの欠陥を利用。Discourseは修正版イメージと画像処理の隔離を案内 | 上流に修正があるだけでなく、稼働中のイメージへ反映されているか |
| フォーラムからChatGPT・Codexへ | HacktronはOpenAIのSSOの問題と説明 | あるサービスが侵害されても、他サービスの権限まで渡らないか |
| Codexから連携先のGitHubへ | 社員アカウントから内部リポジトリへの変更提案を実証 | AIアカウントに接続した開発環境が、どこまで操作を許しているか |
画像処理の修正と認証の権限分離は、攻撃の異なる段階を止める対策である。修正版イメージへの更新は今回の入口を塞ぐ一方、サービス間で権限が広がる設計は別に確認する必要がある。画像処理を隔離する対策も、未知の欠陥が残った場合に備える役割を持つ。表の確認点は公表された経路から導ける運用上の含意であり、OpenAIの非公開の認証実装を特定したものではない。
OpenAI側の対応は速かった。Hacktronの時系列では、7月25日の報告から約14時間で修正が確認され、9月1日に6,500ドルの報奨金が支払われたという。ただし、同じ報告に掲載されたOpenAIの説明は、Discourseが運営するフォーラムへのテストを報奨金制度の対象外とし、賞金はOpenAI側の発見を評価したものだと区別している。賞金の支払いを、一連のテストすべてに対する事前承認と読むことはできない。
TechCrunchも9月18日、OpenAIが問題を解消したとすることを報じた。同紙の取材に応じたAIセキュリティ企業Gray SwanのCEO、Matt Fredrikson氏は、OpenAIで起こるなら他社でも起こり得るとの懸念を示している。これは専門家の見解だが、AI企業自身が外部の画像処理ライブラリや認証連携を通じて侵入を許した事例は、モデルの性能だけに目を向ける危うさを浮かび上がらせる。
修正版が稼働環境に届き、あるサービスの侵害が別サービスの権限へ広がらない設計を保てれば、画像処理の入口と、その先の認証連携の両方で攻撃を止める備えができる。