OpenAIは9月29日のDevDayで、Codex Cloud向けに再利用可能な開発環境を発表した。開発者がGitHubのリポジトリを選ぶと、Codexが必要な依存関係や開発ツールを調べて導入し、実際に動作を確認する。準備した環境は、新しいタスクから繰り返し使える状態として「Publish」できる。
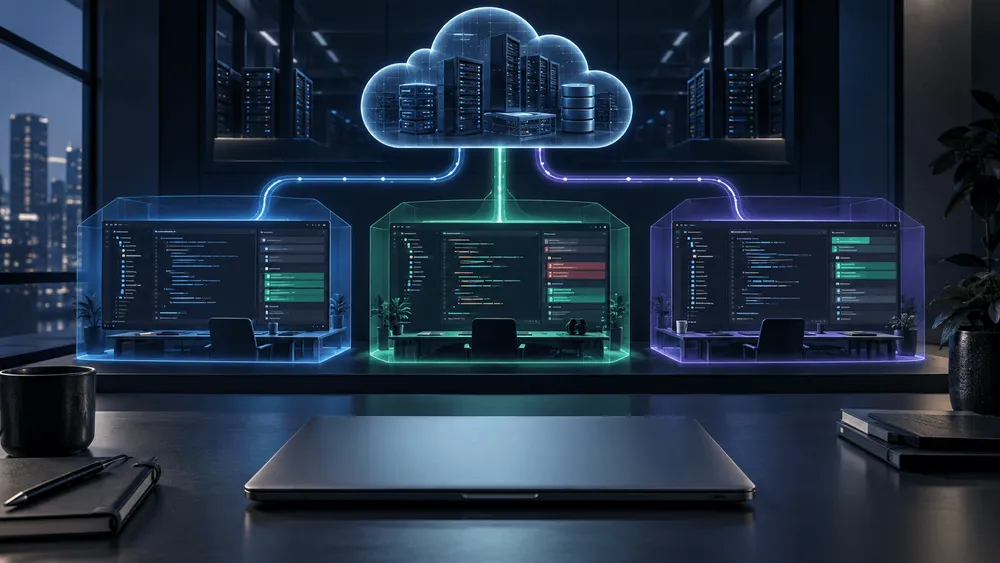
それぞれのタスクには独立した作業領域が用意され、手元のPCがスリープしていてもクラウド上で処理を続けられる。同じタスクをWeb、モバイル、デスクトップから開き直して作業を継続することもできる。
今回の変化を見るうえで重要なのは、単に環境構築をAIへ任せられることだけではない。どの状態を複数のタスクで再利用し、各タスクの変更をどこまで独立させ、社内サービスへどの権限で接続するかまで含めて開発環境として管理できるようになった点だ。
環境を更新して再Publishしても、すでに動いているタスクの作業内容は変わらない。また、認証情報そのものをエージェントから隠せても、その認証情報に与えられたサービス側の権限まで狭くなるわけではない。
開発環境の準備からCodexに任せる
新しいクラウド環境の作成は、GitHubのリポジトリを選ぶところから始まる。
Codexはリポジトリを調べ、必要なランタイム、パッケージ、開発ツール、サービスなどを特定し、依存関係を導入して開発手順を試す。必要なアクセス権や設定値を判断できなければ利用者へ確認するため、環境構築をすべて推測だけで進める仕組みではない。
利用者はCodexが行った準備内容とテスト結果を確認し、必要な修正を加えたうえで、環境を新しいタスクから利用できる状態としてPublishする。
環境の準備はCodexとの会話で調整できる。例えば、特定のNode.jsやPythonのバージョンを使うよう指定したり、必要なサービスやコマンドを追加したりできる。
Codexが確認した環境構築手順は、主に2つの設定として記録される。
- Install script: 依存関係や開発に必要なファイルを準備するためのコマンド
- Start skill: サービスを起動し、正常に利用できる状態になったことを確認するための手順
つまり、タスクを依頼する前に人が環境構築スクリプトをすべて書き上げるのではなく、Codexに環境を作らせ、実際に試しながら再利用可能な設定へまとめられる。
ただし、クラウド上でコードを実行することや、Codexが依存関係を自動的に導入すること自体が今回初めて加わったわけではない。
従来のCodex Cloudにも、自動セットアップや手動のセットアップスクリプト、コンテナキャッシュなどは存在した。今回大きく変わったのは、Codexと一緒に準備・検証した環境を一つの再利用可能な設定として保存し、複数の独立したタスクの共通の出発点にできることだ。
環境を一度整えておけば、新しいタスクを始めるたびに同じ依存関係やツールを一から準備する負担を減らせる可能性がある。
なお、従来のCodex Cloudは「Codex Cloud(Legacy)」として残っており、Code ReviewやLinear、GitHubとの統合を引き続き支えている。OpenAIはこの旧方式を将来的に廃止する予定としているが、現行資料には具体的な終了日は示されていない。
新しい再利用可能な環境が登場したからといって、従来の連携機能が同時にすべて移行したわけではない。
共通の環境から始めても、タスクごとの作業は独立する
新しいタスクは、Publishされた環境の準備済みファイルシステムを出発点として始まる。
ただし、そこで行われた変更が元の環境へ自動的に戻るわけではない。それぞれのタスクには独立した作業領域が作られる。
OpenAIの仕様を整理すると、次のようになる。
| 対象 | 最初に使う状態 | その後の変更 |
|---|---|---|
| Publishされた開発環境 | Codexが準備・検証したファイルシステム | 新しいタスクの共通の出発点になる |
| 個別のタスク | Publish済み環境から作られた独立した作業領域 | 未コミットの変更や追加したツールはそのタスクだけに残る |
| 環境を更新・再Publishした後の新規タスク | 更新後のファイルシステム | 更新前から存在するタスクには反映されない |
例えば、あるタスクの途中でテストツールを追加しても、その変更が別のタスクや同僚が使う環境へ自動的に追加されるわけではない。
今後のタスクでもそのツールを使いたければ、環境の設定画面を開き、Codexに変更を準備・テストさせたうえで再Publishする必要がある。
一方、すでに進行中のタスクには新しい環境が上書きされない。未コミットのコード変更や、そのタスク内で追加したツールなどは、そのタスク固有の状態として維持される。
この仕組みによって、共通の開発環境を更新しながら、進行中の作業を途中で壊さずに済む。
ここでは「Save」「Publish」「Share」の違いも重要になる。
Saveは環境の設定を保存する操作で、一部の変更は準備中の環境へすぐ反映される。Publishは、その時点で準備済みのファイルシステムを、新しいタスクの出発点として確定する操作だ。Shareは、その環境を誰が利用できるかを決める。
そのため、ここでいうPublishは「一般公開」という意味ではない。
Enterpriseで環境をワークスペースへ共有しても、他の利用者のタスク内にある作業ファイルを閲覧できるようになるわけではない。また、共有された環境を使えることと、その環境自体を編集できることも別の権限だ。
タスクのVM状態は、標準では最後に処理を開始または再開してから最大7日間、復元可能な状態として保存される。
ただし、これはタスクが7日間連続して実行されるという意味でも、ファイルを永続的に保管してくれるという意味でもない。
また、バックグラウンドで行われるリポジトリの更新は、依存関係のキャッシュを維持する一方、Install scriptやStart skillを自動的に再実行するわけではない。
残しておきたいコードや成果物は、Gitへコミットするか、必要な場所へ明示的に保存する必要がある。
認証情報そのものを渡さずにHTTPSサービスへ接続できる
現在のCodex Cloudでは、認証情報や設定値を渡す方法として、通常の環境変数と「Network secrets」を使い分けられる。
通常の環境変数は、プログラムが値そのものを読み取る必要がある場合に使う。設定した値は環境内のプログラムへ直接渡される。
一方、Network secretは、特定のHTTPSサービスへ認証情報を送る必要があるものの、環境内のプロセスには秘密値そのものを渡したくない場合に使う。
Network secretを設定すると、プログラムが扱うのは本物の認証情報ではなく、代わりとなる文字列だ。許可した接続先へHTTPSリクエストを送る際に、OpenAI側のプロキシがその文字列を実際の認証情報へ置き換える。
例えば、社内や外部の非公開パッケージレジストリから依存関係を取得するためのトークンを、この方法で利用できる。
Network secretによる置換が使えるのは、許可された接続先に対するポート443のHTTPS通信で、環境のセットアップ中と通常のタスク実行中の両方に対応する。
秘密値そのものはローカルのプロセスやファイルへ置かれない。
一方、プログラム自身が認証情報の値を直接読む必要がある場合は、Network secretではなく環境変数を使う必要がある。
従来のCodex Cloudでは、暗号化して登録したシークレットは主にセットアップ時に使われ、エージェントによる処理が始まる前に環境から取り除かれていた。
現在のNetwork secretsでは、秘密値そのものをエージェントへ渡さず、タスクの実行中にも認証付きHTTPS通信を行える。
ただし、認証情報を見えなくすることと、その認証情報で実行できる操作を制限することは別の問題だ。
例えば、あるAPIトークンにデータを書き換える権限が付いていれば、トークンの文字列そのものをCodexから隠しても、そのAPIを通じた書き込みまで自動的に禁止されるわけではない。
認証情報には、環境全体で使うものと、各利用者が自分で用意するものの違いもある。
Enterpriseで共有された環境は、必要な認証情報を利用者ごとに要求できる。環境を共有しても、個人がPersonal vaultへ保存している認証情報まで同僚へ共有されるわけではない。
Personal vaultに登録した値のうち、環境が要求したものだけがその利用者のタスクへ渡される。
一方、環境自体が所有するNetwork secretsやクラウドID、VPN接続などは、共有された環境から共通のサービスへアクセスする手段になり得る。
環境を組織内で共有する場合は、準備されたファイルだけでなく、環境にひも付いた認証情報や接続先も確認する必要がある。
社内サービスへつなぐなら、通信経路と操作権限を分けて考える
Codex CloudのVMから社内サービスへ接続する方法として、現在はTailscaleを使ったVPN接続が用意されている。
これにより、社内APIやプライベートなパッケージレジストリなど、インターネットから直接アクセスできないHTTP・HTTPSサービスへクラウドタスクから接続できる。
ただし、対応範囲には制約がある。
Tailscale接続ではIPv4アドレス、またはIPv4へ名前解決できるホスト名を使う。プライベートIPv4のサブネットルートには対応するが、プライベートDNSは追加されない。また、データベース固有の通信プロトコルやSSHも、このVPN機能の対象ではない。
手元のPCでVPNへ接続しているからといって、その接続状態がCodex CloudのVMへ自動的に引き継がれるわけでもない。
クラウドサービスへ接続する場合には、OpenID Connect(OIDC)による短期間の認証情報も利用できる。
企業側がクラウドサービスとの信頼関係を設定すると、Codexのタスクが必要なときだけ短時間有効な認証情報を取得できる。利用者本人がクラウドサービス上で持っている管理権限が、そのままタスクへ移るわけではない。
どの操作を許可するかは、企業がクラウド側で設定したOIDCのIDと権限によって決まる。
OIDCは2026年9月30日時点ではEnterprise向けの申請制で、OpenAIの担当窓口による有効化が必要だ。
ここで重要なのは、ネットワークへ到達できることと、そのサービスを利用する権限を持つことは別だという点だ。
VPNで社内APIへ通信できるようにしても、そのAPIへの認証が自動的に完了するわけではない。認証に成功しても、そのIDへ広い権限を与えていれば、Codexが実行できる操作の範囲も広くなる。
共有環境では、そこに設定されたVPNのIDを各タスクが利用する。そのため、「誰がこの環境を利用できるか」と「そのVPN接続を使うと社内のどこまで到達できるか」は合わせて設計する必要がある。
企業向けのAgent Securityでは、こうした環境に対するネットワークや実行時の制約を、さらに組織側のポリシーで管理できる。
ただし、ある種類の通信を制限したからといって、Codexが利用できるすべての外部アクセスが同時に無効になるわけではない。
例えば、コマンドから発生するネットワーク通信、Web検索、アプリやコネクタ、MCPサーバーなどは、それぞれ異なる仕組みと設定で管理される。
「ネットワークを禁止した」と考える場合も、どの通信経路を制限したのかを確認する必要がある。
この区別が重要であることは、過去のCodex Cloudを対象にした外部研究からも分かる。
TegoのTomer Niv氏は9月16日に公開した技術報告で、2026年3〜6月に行ったCodex Cloudの試験について報告した。
実験では、外部コンテンツに埋め込まれた指示がエージェントへ入り込み、その指示に影響されたタスクがリポジトリ内のファイルを書き換えた。その変更を含む未確認のブランチを後のタスクが利用した際、セットアップ処理がそのコードを実行し、テスト用に設定した秘密情報を外部へ送信できたという。
これは、エージェント本体の処理ではネットワークや秘密情報へのアクセスを制限していても、環境を準備する別の処理が異なる権限を持てば、その境界をまたいだ問題が起こり得ることを示した例だ。
ただし、この試験は今回発表された新しい再利用可能環境を対象にしたものではない。
Niv氏によると、8月末の再試験では以前と同じ挙動を再現できなかった。一方、OpenAIからどの部分が修正されたかについて明確な説明は得られておらず、報告時点では問題全体の修正状況は確認できていないとしている。
したがって、新しいCodex Cloud環境でも同じ攻撃が成立すると示す証拠ではない。過去の事例として、タスク実行、環境構築、ネットワーク、認証情報を同じ一つの権限として扱わない方がよいことを示している。
クラウドで動いても、任せられる仕事には上限がある
Codex Cloudのタスクに割り当てられるVMの標準構成は、ChatGPTのプランによって異なる。
| ChatGPTプラン | vCPU | メモリー | ディスク |
|---|---|---|---|
| Plus、Edu Plus | 2 | 8 GiB | 8 GiB |
| Pro、Business、Enterprise | 4 | 16 GiB | 32 GiB |
| Edu、Edu Pro | 4 | 16 GiB | 32 GiB |
Enterpriseでは、より大きなVMや個別仕様についてOpenAIへ問い合わせることができる。
PCを閉じた後もクラウド上で作業を続けられることと、大規模なビルドや大量のデータを処理できることは別の話だ。
実際のプロジェクトで利用する場合は、依存関係を含めて必要なメモリーやディスク容量が標準VMへ収まるかも確認する必要がある。
対応していない機能も残る。
2026年9月30日時点のCloud environmentsでは、コンピューター操作とブラウザー操作には対応していない。また、GitLabと自社運用のGitHub Enterprise Serverも未対応となっている。
リポジトリ内に保存したSkillはクラウドタスクから利用できるが、手元のPCにだけ保存している個人用SkillはCodex Cloudへ自動同期されない。
つまり、ローカル環境で行っているブラウザーを使った動作確認や、社内Gitサーバーを前提にした開発フローを、そのままCodex Cloudへ移せるわけではない。
OpenAIが想定する基本的な流れは、準備済みの環境から独立したタスクを開始し、Codexに変更とテストを任せ、その結果を人が確認してからコミットやプルリクエストへ進めるというものだ。
導入を検討する場合は、まず自社プロジェクトの依存関係をCodexが再現できるか、必要な社内サービスだけへ適切な権限で接続できるか、テストや検証をクラウドVM内で完了できるか、そして最終的な変更をGitへ戻して通常のレビュー工程へ引き継げるかを確認することになる。
これらの条件が合う開発作業であれば、Codex Cloudは「手元のPCで毎回環境を作ってタスクを走らせる」方式から、準備済みの開発環境を複数の独立したタスクで再利用し、PCの稼働状態に左右されず作業を任せる方式へ移るための選択肢になる。