

AMDとUnslothは2026年11月19日、Unsloth DesktopがAMDのXDNA 2 NPUを使ったローカル推論に対応したと発表した。対応するRyzen AI搭載PCでは、AIエージェントなどのアプリがUnsloth DesktopのAPIを通じて、PC内で動作するAIモデルを利用できる。AMDによると、接続可能なアプリとワークフローは合わせて100を超える。
Unsloth DesktopがNPUに対応するのは今回が初めてだ。AIの演算に特化したNPUに推論を任せることで、GPUを映像処理などに使いながら、同じPCでAIモデルを動かせる。ただし、利用できるモデルはNPUの世代や対応するモデル形式によって異なり、推論に必要なメモリ容量も考慮する必要がある。
AIの推論を担うのはPC内蔵のNPU
AIエージェントは、AIモデルから受け取った応答を基に次の処理を進める。今回の仕組みでは、Unsloth DesktopのOpenAI互換APIが推論リクエストの窓口となる。PC内ではLemonadeがモデルへのリクエストを取り次ぎ、FastFlowLMがXDNA 2 NPUを使って推論を実行する。結果はUnsloth DesktopのAPIを経由してアプリに返される。OpenAI互換APIを利用するため、各アプリがNPU向けの実行機能を個別に実装する必要はない。
AMDが対応アプリとして挙げたのは、Hermes Agent、OpenClaw、Open WebUIなどだ。コーディング支援ツールのClineやGitHub Copilot、アプリケーション開発フレームワークのLangChainも含まれる。100を超えるという数字は、API経由でNPU上のモデルを利用できるアプリとワークフローの合計を指す。モデルから返された応答を基に、ツールの呼び出しや後続の処理を制御するのは引き続き各アプリの役割となる。
Unslothは、NPUでチャット用のAIモデルを動かしながら、Radeon GPUで動画をレンダリングする使い方を紹介している。AMDは、NPUへの推論処理の移行によって消費電力を抑え、CPUやGPUをほかの作業に利用しやすくなると説明する。ただし、GPUで別の処理を同時に実行するには、メモリに十分な余裕が必要だ。AMDの技術ブログでも、CPUやGPUのリソースをほかのアプリに割り当てられる条件として、利用可能なメモリ容量を挙げている。
WindowsとLinuxで異なる導入条件
Unslothが対応製品として挙げるのは、XDNA 2以降のNPUを搭載したRyzen AI 300、Ryzen AI Max、Ryzen AI 400シリーズだ。Ryzen AI 300にはStrix PointとKrackan Point、Ryzen AI MaxにはStrix Halo、Ryzen AI 400にはGorgon Pointが含まれる。Unslothの公式ガイドでは、対応OSをWindows 11とLinuxの両方としており、いずれもx64環境が対象となる。
AMDの技術ブログではWindowsでの導入手順を案内しているが、LinuxでもNPUを利用できる。米国の技術メディアPhoronixは、Linux版でもRyzen AIのNPUが動作することをAMDに事前確認したと報じている。Unslothの公式ガイドによると、Linuxではカーネル7.0以降に含まれるamdxdnaドライバ、または旧カーネル向けのamdxdna-dkmsを使用する。さらに、NPUのファームウェアを更新し、プロセスがメモリを固定できる容量の上限を定めるmemlockを無制限に設定する必要がある。
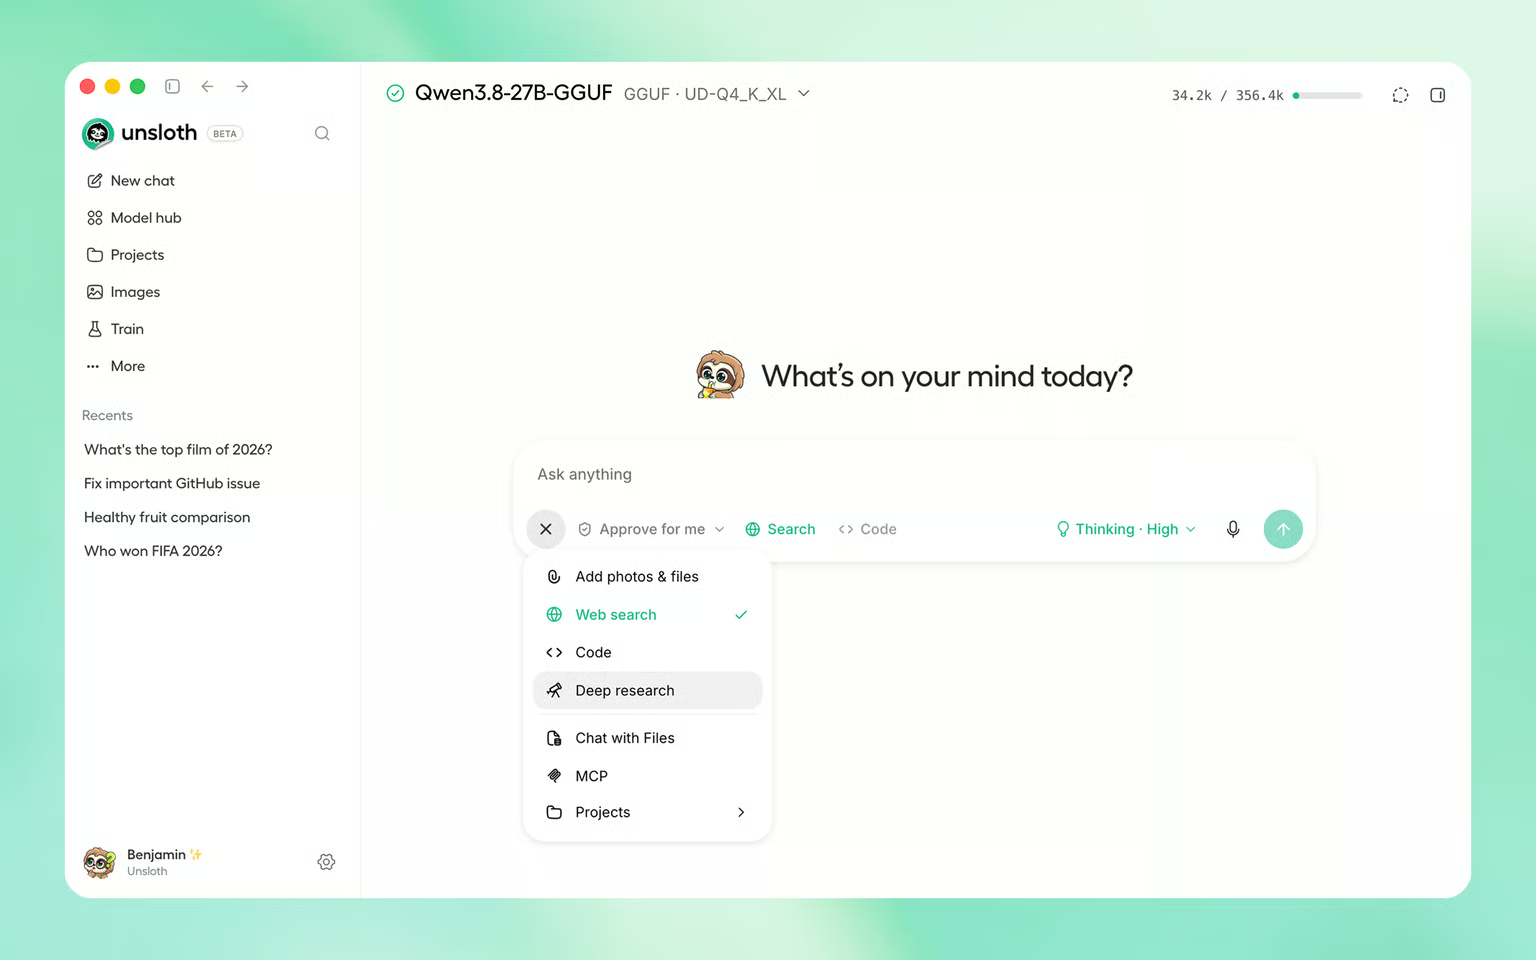
対応PCでは、Unsloth Desktopのモデル選択画面からNPU対応モデルを絞り込める。初回セットアップでは「Enable NPU」を選択すると、UnslothがFastFlowLMをダウンロードし、NPUドライバのバージョンを確認する。セットアップが完了すれば、モデルハブのNPUフィルターからFastFlowLM対応モデルを探し、ダウンロードして利用できる。
利用できるモデルを左右する共有メモリ容量
NPUで実行できるのは、FastFlowLM向けの4ビット量子化形式「Q4NX」に対応したモデルだ。量子化とは、モデルの重みを少ないビット数で表現し、データ容量を削減する手法である。ただし、実際の推論ではモデルの重みに加え、入力データや会話の文脈を保持するためのメモリも必要になる。そのため、モデルの配布ファイルを保存できることと、希望するコンテキスト長で推論を実行できることは別の条件となる。
Unslothは、対応モデルの一覧で配布サイズと推奨システムRAMを公開している。例えば、Qwen3.6-35B-A3B-NPU2の配布サイズは20.6GBで、推奨RAMは64GBだ。一方、Qwen3-VL-4B-Instruct-NPU2は配布サイズが3.9GB、推奨RAMが16GBとなっている。このように、必要なメモリ容量はモデルによって大きく異なる。画像や音声、ツール呼び出しへの対応状況も、Unsloth公式ガイドのモデル一覧で確認できる。
AMDが実演に使用したのは、総パラメータ数350億の混合専門家モデル(MoE)であるQwen3.6-35B-A3Bだ。同モデルを最大のコンテキスト長で動かすには、NPUが利用できるメモリとして約28GBが必要になる。AMDの技術ブログでは、Windowsの既定の共有メモリ割り当てを50%とし、この条件を満たす構成としてシステムRAMを64GB搭載したPCを案内している。つまり、約28GBはNPUによる推論に必要な容量であり、64GBは共有メモリの割り当てを考慮したPC全体の搭載容量を指す。
Unsloth Desktopは、既定の自動設定ではモデルを読み込む時点の空きRAMに応じてコンテキスト長を決定する。モデルの読み込み前に、コンテキスト長を手動で設定することも可能だ。例えば、AIエージェントに長い文書を処理させながらGPUで動画をレンダリングする場合、両方のアプリを動かした状態で、必要なコンテキスト長とメモリ容量を確保できるかが重要になる。


