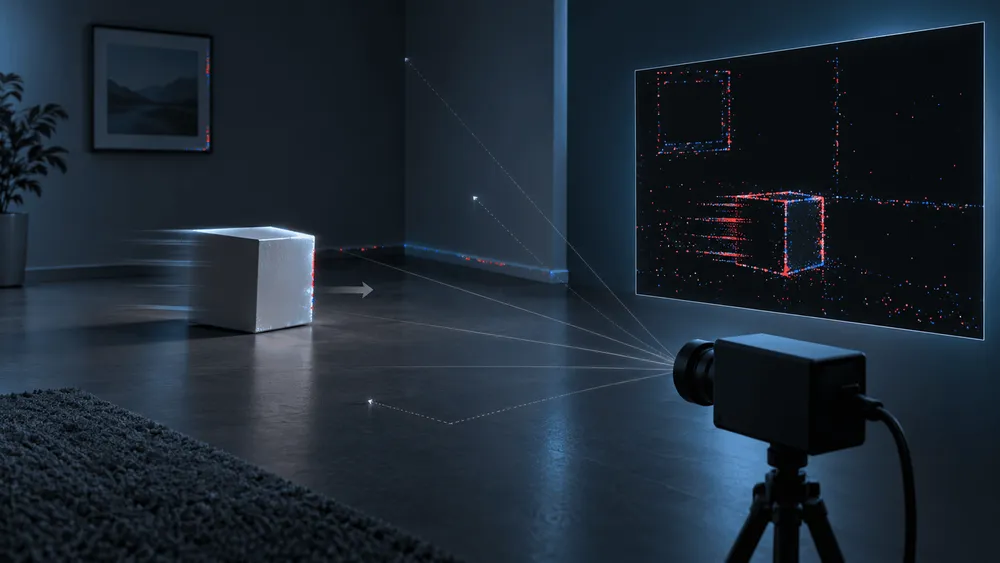
千葉大学などの研究チームは9月30日、動きのある3D空間から「イベントカメラ」の出力を直接生成する、新たなシミュレーション手法を発表した。イベントカメラは、通常のカメラとは異なり、画素ごとに明るさの変化を検出する。今回の手法では、光の経路を追跡して各画素の明るさを計算するとともに、明るさが変化する時刻を効率よく特定する。従来のように一定間隔で大量の画像を生成する必要がなく、計算量を抑えながら、画像と画像の間に生じる変化も捉えられる。画素ごとに異なるタイミングで情報を出力するイベントカメラの特性に合わせて、光の計算方法と時刻の探索方法を工夫したことが特徴だ。
研究成果は、学術誌「IEEE Transactions on Visualization and Computer Graphics」に9月17日付でオンライン公開された。共同発表によると、統計的な手法を用いて不要な計算を省き、GPU向けの最適化を組み合わせることで、二分法だけを使った場合と比べて計算時間を約3分の1に短縮した。今回の研究は、実際のイベントカメラを使ったAIの認識性能を向上させたものではない。AIの学習や性能評価に利用する合成データを、より効率的かつ正確に生成するための技術だ。
イベントカメラの再現が難しい理由
通常のデジタルカメラは、画面全体を一定の時間間隔で撮影する。一方、イベントカメラは画素ごとに独立して動作し、明るさの変化が一定のしきい値に達したときだけ情報を出力する。出力されるデータには、明るさが変化した画素の位置、変化が起きた時刻、明るくなったか暗くなったかを示す情報が含まれる。一定間隔で撮影した画像を並べる通常の動画とは、根本的に仕組みが異なる。
イベントカメラの基本的な動作モデルでは、対数で表した明るさの変化が一定のしきい値に達すると、イベントが発生する。検出するのは明るさそのものではなく、前回の基準となる明るさからの変化だ。
イベントカメラが高速で移動する物体の追跡などで注目されているのは、画面全体の次の撮影を待たず、明るさが変化した画素から即座に情報を得られるためだ。マイクロ秒単位の時間分解能に加え、消費電力が小さく、明暗差の大きい環境にも対応できるという特徴がある。
しかし、この仕組みをCGで再現するのは簡単ではない。
通常の動画と同じように、一定間隔で画像を生成してイベントカメラの出力を再現しようとすると、膨大な計算が必要になる。共同発表によると、マイクロ秒単位の時間分解能を画像の連続生成によって実現するには、わずか1秒間のシーンに対して数十万枚もの画像を計算しなければならない。光の反射などを精密に再現しようとすれば、計算量はさらに増大する。
生成する画像の枚数を減らし、画像と画像の間を補間する方法もある。しかし、元の画像には記録されていない変化を正確に推定できるとは限らない。
例えば、撮影間隔の間に物体が高速で通過したり、明るさが急激に変化したりすると、イベントを取りこぼしたり、実際には起きていないイベントを誤って生成したりする可能性がある。
そもそも、画面全体を一定間隔で計算する方法は、画素ごとに異なるタイミングで発生するイベントを再現するのに適しているとはいえない。
光の計算とイベントの発生時刻の探索を組み合わせる
今回の研究では、一定間隔で画像を生成する従来の方法とは異なり、必要な画素の明るさを、必要な時刻に直接計算する手法を採用した。
その基盤となるのが「パストレーシング」だ。パストレーシングは、光が物体に反射したり屈折したりする過程を追跡し、カメラに届く光を計算する技術である。複数の光の経路を調べることで、各画素の明るさを推定する。
ただし、パストレーシングによる計算には大きな負荷がかかる。そこで研究チームは、イベントが発生する時刻を効率よく特定するために「二分法」を組み合わせた。
二分法は、探索する範囲を半分ずつ狭めながら、目的の値を探す方法だ。今回の研究では、この仕組みを利用して、明るさの変化がしきい値に達する時刻を探す。
あらかじめ全ての時刻について画像を生成するのではなく、イベントが発生すると考えられる時刻に計算を集中させることで、無駄な処理を減らしている。
さらに、研究チームは統計的仮説検定を利用し、不要な計算を早期に終了させる仕組みも導入した。
パストレーシングでは、調べる光の経路によって明るさの推定結果にばらつきが生じる。今回の手法は、このばらつきを考慮したうえで、特定の時間区間ではイベントが発生しないと統計的に判断できた場合、その区間の探索を打ち切る。
単に画面が暗い、あるいは物体が動いていないといった見た目の条件で計算を省くわけではない。推定結果の統計的な性質を利用して、計算を続ける必要があるかどうかを判断する。
論文の要旨によると、光の経路を高速に計算するハードウェア支援機能に加え、モーションブラー機能を利用した時間補間や、処理が必要なデータだけをまとめるGPU向けの最適化も採用している。
一般的な描画ソフトに明るさの計算を任せる方式では、描画処理の内部にイベントカメラ特有の最適化を組み込むことが難しい。今回のように、光の計算とイベントの発生時刻の探索を一体化することで、必要な部分に計算を集中させやすくなる。
もっとも、統計的な手法によって計算を打ち切る以上、あらゆる条件で誤りが発生しないと保証されるわけではない。計算量の削減効果だけでなく、どの程度の精度を維持できるかも重要な評価項目となる。
先行研究との違いは、イベントの発生時刻を直接探す点にある
研究チームの真鍋悠一郎氏らは、2024年に発表した先行研究でも、パストレーシングと仮説検定を組み合わせたイベントカメラのシミュレーション手法を提案している。
ただし、当時の手法は、一定の時間間隔で計算を進めながら、イベントが発生する可能性の低い画素について、光の経路を調べる回数を減らすものだった。
今回の研究では、この手法をさらに発展させた。任意の時刻における画素の明るさを計算できるようにし、イベントが発生する時刻そのものを絞り込む仕組みを導入している。
一方、イベントカメラのシミュレーションに光の物理計算を利用する研究は、ほかにも存在する。
例えば、香港大学などが開発した「EventTracer」は、比較的少ない光の経路をサンプリングして高頻度のRGB画像を生成し、軽量なニューラルネットワークを使ってイベントデータに変換する。
また、通常の動画からイベントデータを生成する「v2e」は、動画の時間補間に加え、実際のイベントカメラに近い応答を再現するためのセンサーモデルを備えている。
したがって、従来の手法を全て、単純に画像間の明るさの差を計算するだけの方式と捉えるのは正確ではない。
それぞれの手法について、入力データ、明るさを計算するタイミング、イベントの生成方法を整理すると、次のようになる。
| 方式 | 入力データと明るさの計算方法 | イベント生成における工夫 |
|---|---|---|
| 同チームの2024年の手法 | 3D空間を一定の時間間隔で評価 | 仮説検定によって光の経路の計算を早期に終了 |
| v2e | 通常の動画を時間方向に補間 | しきい値やノイズなど、実際のセンサーに近い応答をモデル化 |
| EventTracer | パストレーシングによって高頻度のRGB画像を生成 | 専用のニューラルネットワークを使って画像からイベントデータに変換 |
| 今回の手法 | 3D空間内の任意の画素について、任意の時刻の明るさを直接計算 | 二分法による時刻の探索と、仮説検定やGPU向け最適化によって計算量を削減 |
このように、パストレーシングを利用しているかどうかだけでは、各手法の違いを十分に説明できない。明るさを計算するタイミングと、そこからイベントを生成する方法が重要な比較ポイントとなる。
なお、この表は先行論文や各開発者の説明、今回の共同発表をもとに、それぞれの設計上の違いを整理したものだ。GPUや解像度、しきい値、時間分解能などの条件を統一した性能比較ではないため、処理速度や生成品質の優劣を示すものではない。
今回の研究の特徴は、光の振る舞いを物理的に計算するだけでなく、一定間隔で画像を生成する方式から離れ、イベントの発生時刻を直接求める仕組みを実現した点にある。
計算時間は約3分の1に。生成精度はどう変わったのか
今回の共同発表では、計算時間の短縮とイベント生成の精度について、それぞれ比較結果が示されている。
まず、計算時間については、二分法だけを利用する構成と、統計的な計算の打ち切りやGPU向けの最適化を組み合わせた構成を比較している。
その結果、後者の計算時間は前者の約3分の1になった。
注意したいのは、既存のイベントカメラシミュレーター全般と比較して3倍高速になったわけではないことだ。あくまでも、今回の手法において、二分法だけを利用した場合と各種最適化を組み合わせた場合の比較結果である。
一方、生成するイベントデータの品質については、別の比較が行われている。
共同発表の図1では、CGで作成した室内の奥に置かれた箱を左右に滑らかに動かし、イベントが発生した位置と時刻を可視化している。
研究チームによると、一定間隔で生成した画像をもとにイベントを再現する既存方式では、イベントの誤検出や取りこぼしが発生し、可視化した結果に不連続な部分が現れたという。
これに対し、今回の手法ではそうした不連続性が見られず、比較の基準となる「Reference」に近い結果が得られたとしている。
ただし、これはCGで作成したシーンにおけるイベント生成の品質を示した結果であり、実際のイベントカメラで撮影したあらゆるデータを、同じ精度で再現できると証明したものではない。
イベントカメラでは、どの画素で信号が発生したかだけでなく、その信号がいつ発生したかも重要になる。そのため、生成結果の見た目が似ているかどうかに加え、イベントの位置や発生時刻の正確さも評価する必要がある。
なお、共同発表には、計算に要した具体的な秒数や使用したGPUの型番、評価に使用したシーンの総数などは記載されていない。
処理速度の再現性を確認し、ほかの手法との性能差を正確に比較するには、GPUや解像度、イベントの検出しきい値、許容する時刻の誤差などの条件をそろえた検証が必要になる。
また、マイクロ秒単位の時間分解能を実現できることと、シミュレーションをリアルタイムで実行できることは別の話だ。時間分解能が高いからといって、それだけでリアルタイム処理が可能になったわけではない。
AIの学習データ生成への応用と、今後の課題
研究チームは、今回の技術がイベントカメラを利用するAIの学習データ生成に役立つと期待している。
イベントカメラは通常のカメラとは異なる形式で情報を出力するため、AIの学習に利用するデータを集めるには専用の機器が必要になる。機器の入手が難しい場合や、さまざまな条件で大量の撮影データを集めたい場合には、データの収集そのものが研究の負担となる。
CGを利用すれば、実際に撮影する前に、物体の配置や動き、照明条件などを変えながら学習用データを生成できる。
今回の手法によってイベントの発生時刻をより正確に再現できれば、物体やカメラの動きによってイベントデータがどのように変化するのかを、条件を制御しながら詳しく調べられるようになる。
ただし、光の振る舞いを正確に計算することと、実際のイベントカメラが出力する信号を忠実に再現することは、必ずしも同じではない。
実際のセンサーでは、画素ごとの検出しきい値にばらつきがあるほか、回路の応答速度や各種ノイズによって、出力されるイベントデータが変化する。
例えば、v2eの公開実装には、画素ごとのしきい値のばらつきや応答帯域を再現する機能に加え、漏れ電流によって発生するイベントやショットノイズをモデル化する仕組みがある。イベントの発生直後に、センサーが次のイベントを検出できなくなる期間も設定できる。
今回の手法が、こうした実機特有の現象をどこまで再現できるのかについては、共同発表と論文の要旨だけでは判断できない。
また、合成データを使って学習したAIが、実際のイベントカメラを利用する環境でも十分な認識性能を発揮できるかどうかは、今後検証する必要がある。
自動運転やロボットなどへの応用を目指すのであれば、シミュレーションで得られた結果が、現実の環境でも通用することを確認しなければならない。今回の発表は、実機を使った物体認識の精度や、自動運転の安全性が改善したことを示すものではない。
今回の研究には、千葉大学の真鍋悠一郎氏と久保尋之准教授、早稲田大学の森島繁生教授、一橋大学の谷田川達也准教授らが参加している。
イベントの発生時刻を正確に再現する今回の技術に、実機特有のノイズやセンサーの応答特性も組み合わせられれば、実際の撮影だけに頼らず、さまざまな条件の学習データを生成できるようになる。現実の環境でAIの認識を難しくしている要因を解明するうえでも、重要な研究基盤となる可能性がある。