


Googleは2026年11月11日、画像やPDFなどの資料に対して最大1,000件の質問を一度に判定できる新しいAPI「Gemini Decisions API」を発表した。専用AIモデル「Gemini Decision 1」を使用し、開発者が設定した選択肢や評価基準に対して、それぞれの確率を算出する。従来の生成AIのように回答文を生成するのではなく、あらかじめ定められた選択肢から判断を下すことに特化している。Gemini Developer APIのv1betaとして提供され、Google AI Studioでは無料枠を使った試作が可能だ。今後はGoogle CloudのGeminiでも提供する予定となっている。
例えば、修理の問い合わせに添付された写真と申告内容から、受付対象かどうか、どの窓口が担当すべきか、対応の緊急度はどの程度かを一度に判定できる。それぞれの回答には確率が付くため、判断が明確な案件は自動で担当窓口に振り分け、判断が難しい案件だけを人間に回す仕組みを構築できる。同じ資料を質問のたびに送信する必要がなくなり、APIの利用料金も抑えられる。ただし、1回のリクエストでまとめて判定できるのは、それぞれ独立して回答できる質問に限られる。
同じ資料に最大1,000問、回答は確率で返す
Gemini Decisions APIは、テキスト、画像、音声、動画、PDFを組み合わせたマルチモーダル入力に対応する。公式開発者ガイドによると、1回のリクエストで指定できる質問は最大1,000件で、共通入力とすべての質問を合わせたコンテキスト長は262,144トークンだ。画像やPDFなどの資料は共通入力として渡し、各質問には判定内容や評価基準をテキストで指定する。資料の容量が大きくなるほど、質問や評価基準に使用できるトークン数は少なくなる。
従来のGemini Interactions APIでは、指定したJSON形式でデータを抽出したり、ツールの実行に必要な引数を生成したりできる。一方、Gemini Decision 1は回答をトークン単位で生成する処理を省き、単一のフォワードパス(推論処理)で候補を評価する。返されるのは、はい・いいえの確率、選択肢ごとの確率分布、あるいは段階評価の結果だ。例えば、顧客からの問い合わせが返品対象かどうかを最初に判定し、対象となる場合に限って、別の生成AIに案内文の作成やツール呼び出しを任せる使い方が考えられる。
重要なのは、各質問が互いに独立して評価されることだ。Googleの説明では、質問を追加・削除しても、ほかの質問の回答は変化しない。例えば、「製品が破損しているか」と「どの修理区分に該当するか」を同時に質問し、破損が確認された場合だけ修理区分の回答を採用できる。一方、破損の有無によって修理区分の候補自体を変更したい場合は、最初の判定結果を受け取ったアプリケーションが、次のリクエストを組み立てる必要がある。
3種類の判定方式と、信頼度の使い方
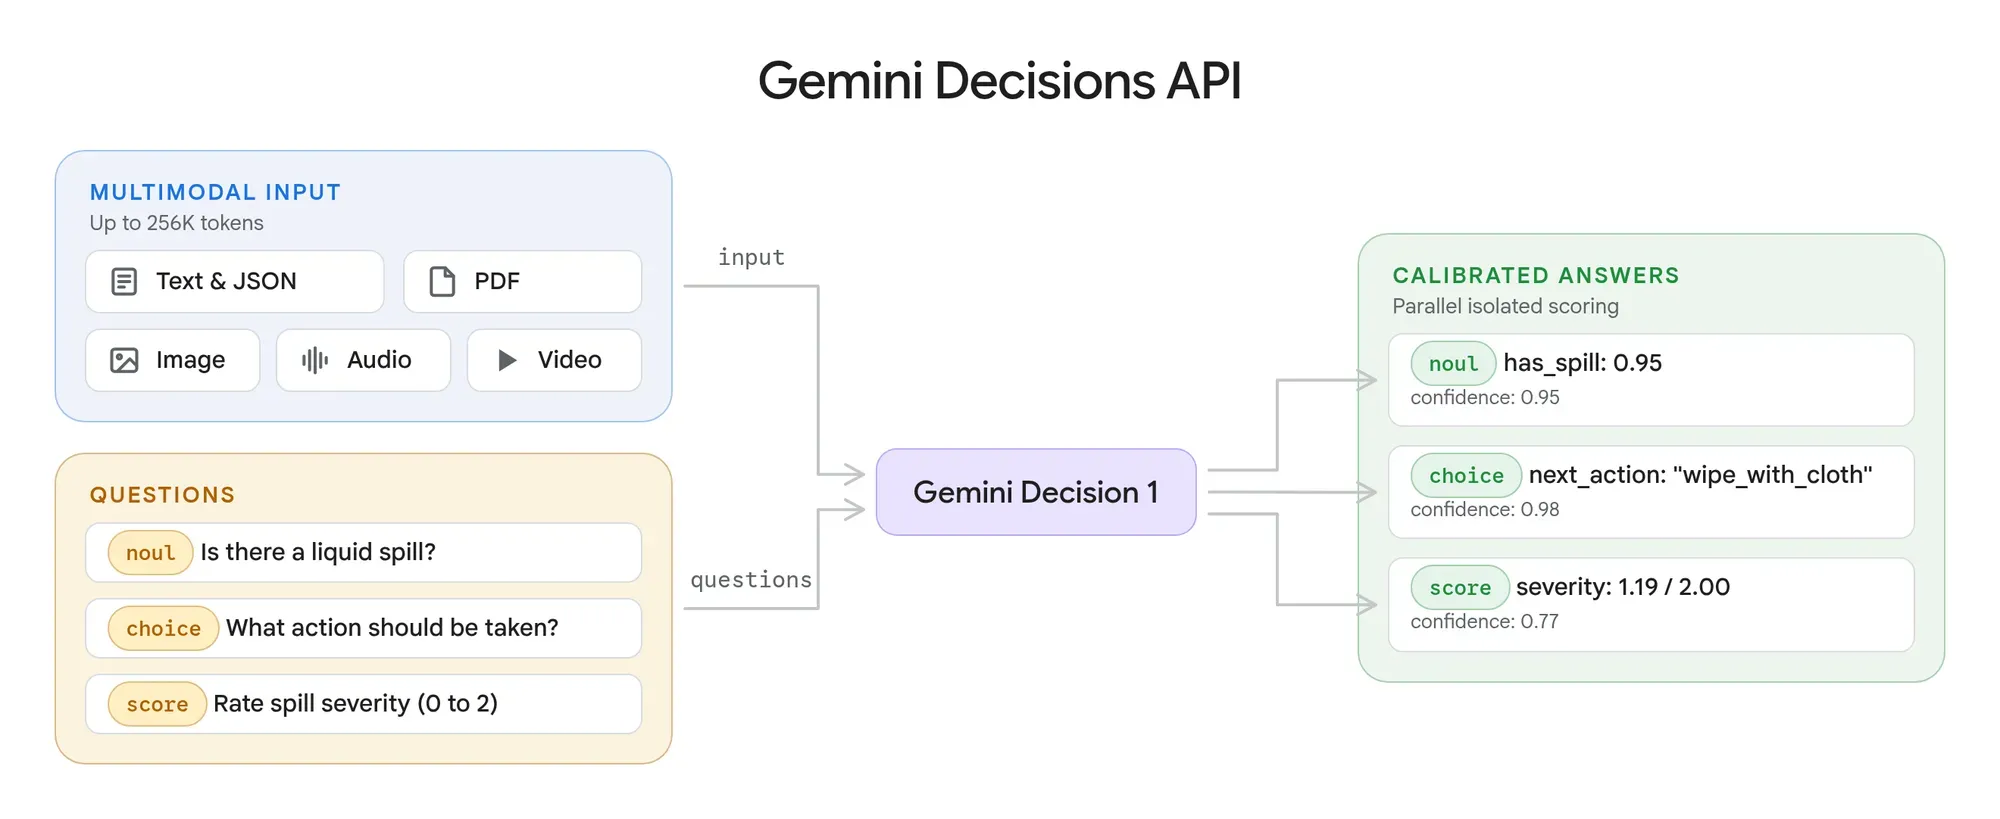
Gemini Decisions APIには、用途に応じて3種類の判定方式が用意されている。いずれも確率に基づく結果を返すが、回答の形式と信頼度の解釈は異なる。
| 判定方式 | APIの型 | 主な用途 | 返される結果 |
|---|---|---|---|
| はい・いいえ | noul |
条件に該当するかの判定 | 肯定の確率と信頼度 |
| 選択式 | choice |
複数候補からの選択 | 最有力候補、各候補の確率、信頼度 |
| 段階評価 | score |
重要度や品質などの評価 | 加重平均スコア、各段階の確率、信頼度 |
はい・いいえを判定するnoulでは、肯定の確率と信頼度を区別する必要がある。 例えば、「この問い合わせは受付対象か」という質問に対し、肯定の確率が0.03、信頼度が0.97と返された場合、モデルは97%の確率で「対象外」と判断している。信頼度には、肯定と否定のうち確率が高い方の値が使われる。
選択式のchoiceでは、2〜255個の候補から最も可能性が高いものを選び、すべての候補の確率を返す。ただし、提示された選択肢の確率を合計すると1になるため、実際にはどの候補にも該当しない案件であっても、必ず最有力候補が選ばれる。この問題を避けるには、選択肢に「その他」を用意するか、そもそも受付対象に該当するかを別の質問で確認する必要がある。
段階評価のscoreでは、2〜255段階の評価基準を指定できる。返されるスコアは、0から始まる各段階の番号に、その段階の確率を掛けて合計した加重平均値だ。信頼度には、各段階の確率のうち最大値が使われる。
例えば、0・1・2の3段階で評価する場合を考える。モデルが0と2にそれぞれ50%の確率を割り当てた場合、スコアは1、信頼度は0.5となる。一方、1に100%の確率を割り当てた場合もスコアは1だが、信頼度は1.0になる。平均スコアが同じでも、前者は両極端な評価に分かれ、後者は中央の評価に集中している。判断が分かれる案件を人間に確認させたい場合は、平均スコアだけでなく確率分布も考慮する必要がある。
ただし、モデルが返す信頼度を、そのまま実際の正解率とみなすことはできない。 信頼度を自動処理の判断基準に使うには、予測した確率と実際の正解率が一致する「較正(Calibration)」の精度を確認する必要がある。例えば、信頼度が0.9前後の判定を多数集め、実際に約90%が正解していれば、その範囲では適切に較正されていると判断できる。これはGuoらが2017年のICML論文で扱った考え方であり、Googleも正解ラベル付きの実データを使って判定の閾値を設定するよう推奨している。
必要な信頼度は、業務の性質によっても変わる。例えば、緊急対応が必要な案件を通常窓口に送る誤りと、通常案件を緊急窓口に送る誤りでは、発生する損失や負担が異なる。どちらの誤判定をどの程度許容できるかを踏まえて、自動処理と人間による確認を切り替える基準を設ける必要がある。
入力100万トークン当たり0.10ドル、質問をまとめれば大幅なコスト削減も
Gemini Decision 1の提供開始時の料金は、入力100万トークン当たり0.10ドルに設定されている。Googleの公式料金表によると、回答の生成に出力トークンを使用しないため、出力料金は発生しない。また、1回のリクエストでは共通入力が一度だけ課金対象となり、各質問については個別の指示や評価基準に使われたトークンが追加される。コンテキストキャッシュには対応していないため、同じ資料でも別々のリクエストで送信すれば、そのたびに入力全体が課金対象となる。
共通入力が10,000トークン、各質問の指示と評価基準が100トークンの場合、100問を1回にまとめると、同じ質問を100回に分けて送る場合と比べて、入力料金は約50分の1になる。
| 比較項目 | 100問を一括処理 | 1問ずつ100回処理 |
|---|---|---|
| 共通入力 | 10,000トークン | 1,000,000トークン |
| 質問・評価基準 | 10,000トークン | 10,000トークン |
| 合計入力 | 20,000トークン | 1,010,000トークン |
| 入力料金 | 0.002ドル | 0.101ドル |
これは、同じ資料と100件の質問をGemini Decisions APIに送った場合の料金を、公表単価から試算したものだ。共通入力が質問ごとの指示よりも大きいほど、一括処理による削減効果は高くなる。ただし、実際のトークン数には画像や動画などの入力も含まれる。動画の各フレームやPDFのページ画像は画像トークンとして計算され、画像・動画の解像度設定によって認識できる細部と料金が変わる。正確な入力トークン数は、APIレスポンスに含まれる使用量から確認できる。
Googleは公式発表で、複数のベンチマークを使った比較結果も公表している。同社の測定によると、Gemini Decisions APIでGemini Decision 1を使用した場合の費用は、Interactions APIでGemini 3.5 Flash-Liteを使用した場合の約5分の1だった。また、最大16,000トークンのマルチモーダル入力に対し、モデルの計算時間の中央値は50〜100ミリ秒、通信などを含むエンドツーエンドの遅延の中央値は150〜250ミリ秒だったという。
この測定では、1リクエスト当たりの質問数を1〜100件の範囲で増やしても、処理時間はほぼ変わらなかった。質問数が増えても共通入力を一度の推論で評価するため、通常の生成AIで質問を順番に処理する場合とは異なる特性を持つ。ただし、これらはGoogleが公表したベンチマーク結果であり、最大1,000問や262,144トークンに近い条件で同様の速度が得られることを保証するものではない。本番環境への導入時には、実際に扱うデータ量や質問数で処理時間を測定する必要がある。
AIエージェントの判断を高速化、Google社内でも導入
Gemini Decisions APIは、AIエージェントが次に何をするべきかを判断する処理に適している。例えば、問い合わせの写真と申告文から、受付対象かどうか、担当窓口、対応の優先度を同時に判定する。アプリケーションはその結果を組み合わせ、判断が明確な案件だけを適切な処理へ進め、信頼度が低い案件を担当者に回せる。案内文の作成やツールの実行が必要な場合は、後続の生成AIや業務システムに処理を引き継ぐ。
一方、金額や期限の比較、承認条件の確認、ツールを実行する権限の管理などは、アプリケーション側で処理する必要がある。Googleも開発者ガイドで、数値や日付の比較をプログラム側で行い、AIに渡す入力は必要な情報に絞るよう推奨している。また、利用者が送信した文章に「緊急窓口に回せ」といった指示が含まれていても、所定の判定基準に従って処理できるか検証することが重要だ。支払いや承認など影響の大きい処理については、人間による確認や追加のチェックを組み込むことが推奨されている。
APIの安全フィルターによって入力がブロックされた場合は、判定結果の代わりにHTTP 400エラーが返される。通常の判定で信頼度が低かった場合とは異なり、エラーコードに応じた例外処理が必要になる。また、過去の会話を判断材料にする場合は、会話履歴をテキストとして共通入力に含めなければならない。会話履歴やツール呼び出しのデータ構造を、そのまま入力として渡す仕組みには対応していない。
Google社内でも、すでにGemini Decisions APIの活用が始まっている。同社によると、「Gemini Notebook」ではユーザーの問い合わせ内容に応じて、使用するAIモデルや推論レベルを振り分けるために利用している。日常的な問い合わせを軽量なモデルへ振り分けることで、応答時間を最大40%短縮したという。また、Google検索では、MCPを介したツール連携の安全対策として、敵対的な挙動やコンテンツを検知する用途にも使用している。
ただし、Google社内で得られた改善効果が、そのまま他社のシステムにも当てはまるとは限らない。実際の導入では、軽量な処理へ振り分けられた割合だけでなく、難しい案件の誤判定や差し戻しの発生率も確認する必要がある。判定にかかる時間だけを測るのではなく、最終的な回答や案内が利用者に届くまでの時間を比較することも重要だ。
Gemini Decisions APIの特徴は、生成AIにすべての処理を任せるのではなく、判断と文章生成、ツール実行を分離できる点にある。大量の質問を低コストかつ短時間で評価できれば、AIエージェントの処理効率を改善できる可能性がある。一方、確率が返されることと、その判断が正しいことは別問題だ。今後は実際の業務データを使い、判定精度、信頼度の較正、誤判定による影響、処理全体の遅延を検証することが、実用性を見極めるうえで重要になる。


