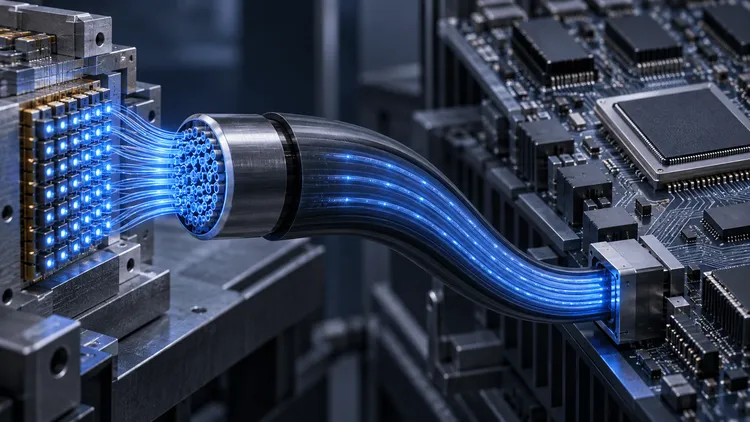
米半導体スタートアップのVolantisは2026年10月1日、光で演算チップとメモリーを接続するAI推論システムの開発に向け、シリーズAで8,800万ドルを調達した。最初のシステム「A-1」について、同日の発表では20兆パラメーターを超えるモデルを対象に、利用者1人あたり最大毎秒1万トークンの生成を目標としている。
演算器へ大量のデータを送り込む配線を光に置き換えることで、メモリー容量とデータ転送速度を同時に引き上げる構想だ。2027年の初納入を目指す開発段階にあり、巨大モデルをどの精度や装置構成で動かすのかが、こうした性能目標を評価するうえで重要になる。
今回の調達はLachy GroomとAbstract Venturesが共同で主導した。John DoerrやSusa Venturesなども参加している。会社ブログによると累計調達額は9,700万ドルで、これまでの出資者にはSam AltmanやJeff Deanらも含まれる。新たに調達した資金は、A-1の開発・商用化と技術者の増員に充てる。
演算チップを待たせる「メモリーの壁」
大規模言語モデルが文章を生成するとき、演算器はモデルの重みや、それまでの処理結果をメモリーから読み出す。演算能力を高めても、必要なデータが十分な速さで届かなければ、演算器は待たされる。Volantisが解消を目指す「メモリーの壁」とは、このデータ供給能力の制約を指す。
推論のどの段階を速くしたいかによって、求められるハードウェアの特性も変わる。NVIDIAの技術解説では、入力文をまとめて処理する段階は並列化しやすい一方、トークンを1つずつ生成する段階では、メモリーからのデータ転送速度が遅延を左右しやすいと説明している。
長い推論やコード生成を1人の利用者が待っているような場面では、後者の速度が応答時間を大きく左右する。
チップ内部に搭載するSRAMは高速だが、容量には限りがある。GPUで使われるHBMは、比較的大きな容量と高いメモリー帯域を両立できるものの、モデルをさらに大規模化しながら1人あたりの生成速度も高めようとすると、データ供給能力が不足する場合がある。
Volantisは会社ブログで、光インターコネクトによって、この容量と帯域の制約を変えることを目指している。
複数の利用者からの要求をまとめて処理すれば、同じモデルの重みを読み出すコストを複数の処理で分担でき、GPUの演算能力を効率よく使いやすくなる。
ただし、システム全体が毎秒何トークンを処理できるかという「総スループット」と、1人の利用者に対してどれだけ速くトークンを返せるかという「利用者あたりの生成速度」は別の指標である。
A-1が掲げる「毎秒1万トークン」は利用者あたりの目標値であり、同時利用者数などの条件が分からなければ、既存システムの総処理性能とは単純に比較できない。
200mm超の光配線、量産実績のあるVCSELを活用
Volantisの技術ページによると、同社の光導波路は200mmを超える距離まで信号を運べる。
光導波路は、光信号を伝える微細な通路である。Volantisはこれをチップ同士を接続する基板上へ組み込み、メモリーを演算チップからより離れた位置に配置できるようにする。
同社は、HBM周辺で使われる高帯域の電気接続について、距離の目安を2〜5mmとしている。それに対して光配線によって接続距離を延ばし、220個を超えるメモリーチップレットを1つのメモリープールとして接続する構想を示している。
HBMを演算チップのすぐ周囲に配置する方式では、チップ周辺に確保できる接続領域と配線距離によって、搭載できるメモリー量が制約される。
光によってより遠くまで接続できれば、演算チップから離れた位置にも多数のメモリーを配置できる。その結果、多数のメモリーチップが持つ帯域を合算して利用できる。
なお、Volantisが示す2〜5mmという数値はHBM周辺の実装を対象とした説明であり、電気通信そのものが数mmまでしか届かないという意味ではない。
光源には、基板へ組み込んだ微小なVCSELのアレイを使う。
VCSELは「垂直共振器面発光レーザー」と呼ばれる半導体レーザーで、光をチップ表面に対して垂直方向へ放射する。A-1では外部レーザーや光ファイバーを使わず、多数の微小VCSELと光導波路によって短距離の光リンクを構成する設計を採る。
同社は多数のリンクを組み合わせ、200TB/sを超える帯域の実現を目指すとしている。
VCSEL自体は新しい部品ではなく、スマートフォンの3Dセンシングなどを通じて大規模な製造基盤が形成されてきた。
Appleは2017年12月、Face IDなどに使うVCSELの生産拡大を支援するため、Finisarへ3億9,000万ドルを拠出すると発表した。
Volantisは、ガリウムヒ素(GaAs)系VCSELの既存の製造・供給基盤を活用し、リン化インジウム系材料に依存する光部品とは異なるサプライチェーンを利用する方針を示している。
既存の量産技術を利用できる点には利点があるものの、微細な光導波路との接続や、大規模な基板へ多数の光部品を実装する工程まで量産できるかどうかは、別途確認が必要になる。
A-1の演算エンジンには、すでに実チップで動作実績のある外部設計IPをライセンスして利用するという。
製品説明を見る限り、Volantis独自の開発の中心は演算器そのものではなく、演算器と大容量メモリーを接続する光インターコネクトにある。光そのものを使って行列演算を行う光コンピューティングとは、光を使う場所が異なる。
10TBで20兆パラメーターのモデルは動くのか
A-1の製品ページでは、メモリー容量10TB、メモリー帯域240TB/sという仕様が掲げられている。
装置サイズは15U、電力枠は20kWであり、GPUチップ単体と直接比較できる単位ではない。
| 項目 | A-1の公表値 | 数値を読む際の条件 |
|---|---|---|
| メモリー容量 | 10TB | モデルの重み以外にも実行時の作業領域が必要 |
| メモリー帯域 | 240TB/s | 完成した装置での持続性能は公開情報から確認できない |
| ウェハー外との入出力帯域 | 10TB/s | メモリー側の240TB/sとは対象が異なる |
| 電力枠 | 20kW | 推論時の実測消費電力とは異なる |
| 装置サイズ | 15U | ラックへ収容する統合システムの仕様 |
出典はVolantis製品ページ。2026年10月2日時点の公表仕様であり、同一条件で行った実機ベンチマークの結果ではない。
10TB/sはウェハー外との入出力帯域を指し、メモリー側の240TB/sとは対象が異なる。公開情報では接続先の詳細まで示されていないため、装置間通信の帯域だと断定することもできない。
ここで、10TBというメモリー容量を20兆パラメーターのモデルに当てはめて考えてみる。
20兆パラメーターの重みだけを保存する場合、16bitなら40TB、8bitなら20TB、4bitでも10TBが必要になる。
| 重み1個あたりの保存精度 | 20兆パラメーターの重み容量 |
|---|---|
| 16bit | 40TB |
| 8bit | 20TB |
| 4bit | 10TB |
計算は「パラメーター数 × 保存bit数 ÷ 8」でバイト数を求め、1TBを10の12乗バイトとして換算した。
たとえば4bitなら、
20兆 × 4 ÷ 8 = 10兆バイト
となり、重みだけで10TBに達する。
ここでは10月1日の発表にある「20兆パラメーター超」という表現の下限として20兆を使い、同じパラメーター数で保存精度だけを変えて計算している。
しかも、これはモデルの重みだけを保存する場合の理論上の容量である。
量子化された重みを扱うための付加情報や、過去の入力・出力を保持するKVキャッシュ、実行時の一時データなどは含まれていない。
モデルが20兆パラメーターを超えれば、4bitで量子化した場合でも重みだけで10TBを超える。
したがって、「10TBのメモリーを持つ」という仕様だけから、単一のA-1で20兆パラメーターを超えるモデルを無条件に動かせるとは判断できない。
実際にどの精度で重みを保存するのか、複数のA-1を組み合わせるのかといった構成の説明が必要になる。
また、モデル全体のパラメーター数と、1トークンを生成するときに実際に使う重みの量も区別する必要がある。
Volantisの製品ページでは、Mixture of Experts(MoE)モデルも対象として挙げている。
MoEでは、モデル全体には非常に多くのパラメーターがあっても、1回の推論ですべての重みを使うわけではない。
そのため、モデル全体の重みを保存するための容量と、1トークンの生成時に実際に読み出す重みの量は一致しない。
したがって、240TB/sというメモリー帯域だけから、20兆パラメーターを超えるモデルで利用者あたり毎秒1万トークンを実現できると計算することもできない。
光リンクの実験結果と、2027年に待たれる実機検証
Volantisは技術ページで、光信号の品質を示すアイパターンや、ウェハースケールでビット誤り率が10のマイナス12乗未満だったとするデータを掲載している。
ただし、これは同社が開発した光リンクそのものについての結果であり、A-1全体で巨大モデルを動かし、毎秒1万トークンを実現したことを示すものではない。
公開情報からは、測定条件の詳細や長時間運転時のデータまでは確認できない。
消費エネルギーについても、評価対象を区別する必要がある。
発表では、光信号の送信から受信までに必要なエネルギーを1bitあたり1ピコジュール未満と説明している。
ただし、これはデータ伝送部分だけの指標である。
実際にモデルが1トークンを生成する際には、メモリーからのデータ読み出しや演算そのものにも電力を消費する。そのため、この光リンクの数値だけから装置全体の電力効率を評価することはできない。
製品ページでは、NVIDIA Rubinと比較して「1ドルあたりのトークン数が15倍」という主張も掲げている。
また、低遅延で動作する1兆パラメーター超のMoEモデルについて、「1ワットあたりのトークン数が6倍」としている。
ただし、比較に使った具体的なモデル名や重みの精度、装置構成、価格条件などは、公開情報では明らかにされていない。
したがって、これらは現段階ではVolantisによる性能・コストの目標または比較主張として扱うべきであり、同一条件の実機ベンチマークで確認された性能差とみなすことはできない。
最初の顧客向けシステムの納入を予定している2027年には、具体的なモデル名や重みの精度に加え、使用した装置台数、入力長、同時利用者数などの条件をそろえた実機試験が重要な判断材料になる。
そこで利用者あたりの生成速度や装置全体の消費電力、コストが明らかになれば、巨大モデルを使うAIエージェントの待ち時間をどこまで短縮できるのか、Volantisの主張を具体的に評価できるようになる。