

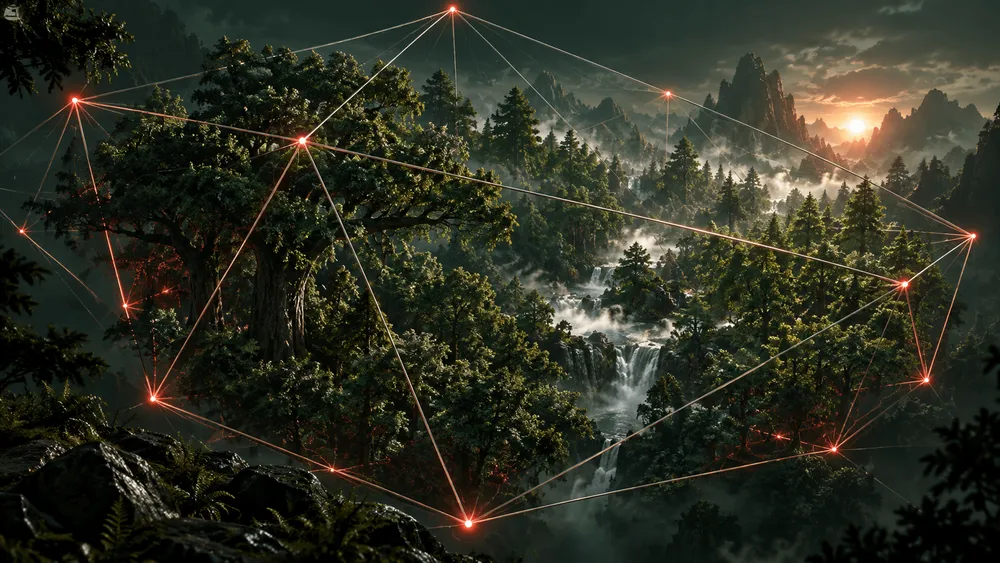
AMDの研究チームは2026年9月17日、25,000本の植物を個別に動かし、Radeon RX 9070 XTで毎秒60フレーム(fps)を超えてレイトレーシングするデモを公開した。植物は最高精細度なら合計28億個もの三角形を、距離に応じたLOD適用後も1フレーム当たり約5億個の三角形を含む。解像度は1080pで、各画素から主光線と影用の光線を追跡したという。これを可能にしたのは、密な三角形を毎フレーム動かす代わりに、形状を包む粗い「四面体ケージ」だけを変形させる研究手法である。
AMDによれば、同じ植生を従来型の動的な下位アクセラレーション構造(BLAS)で扱うと、バウンディング・ボリューム階層(BVH)だけで最大80GB、毎フレームの更新に300ms超が必要になる。四面体ケージ法ではBVHを約1.7GB、全BVHの更新を約3.3msに抑えた。ただし、これはAMDによる自社デモの値であり、独立した第三者測定ではない。
三角形ではなく、粗いケージを動かす
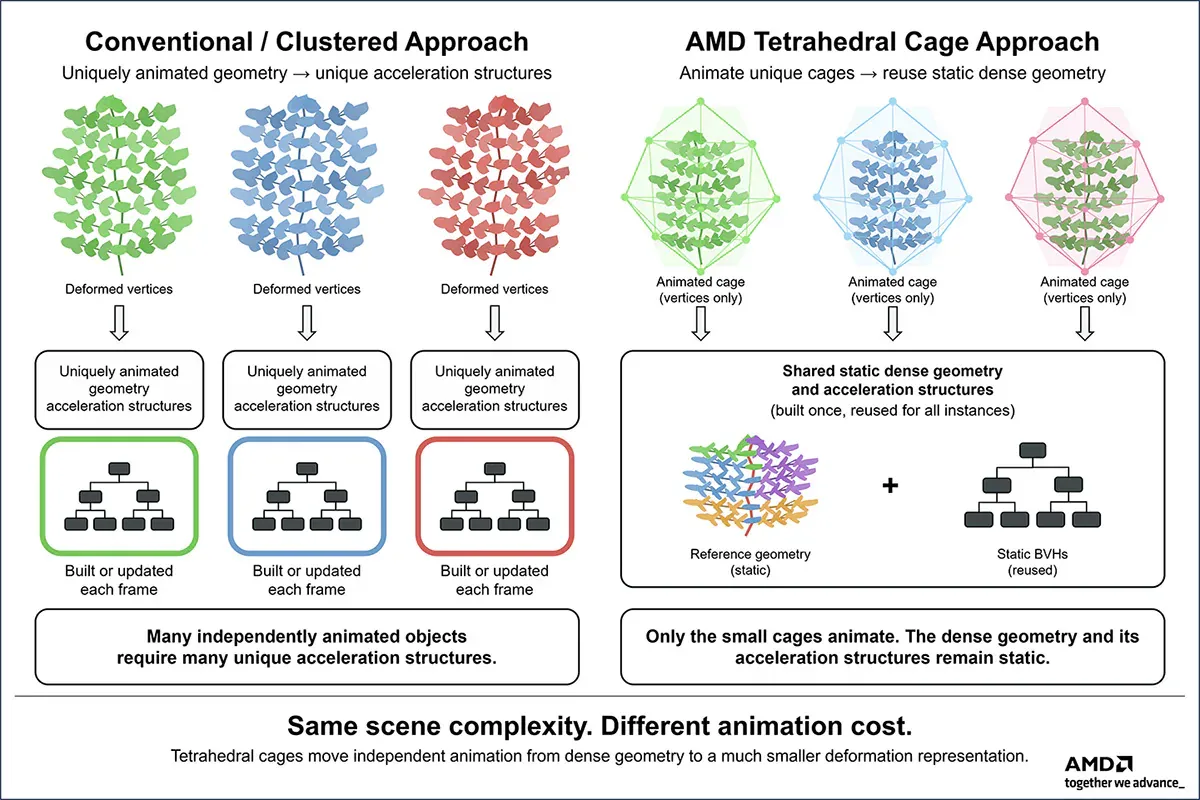
通常の動的レイトレーシングでは、メッシュが変形するたびに、レイの交差判定を高速化するBLASを更新または再構築する。物体の表面が細かく、独立して動く個体が多いほど、保持するBVHと更新処理が膨らむ。植物の葉を構成する三角形すべてを風に合わせて更新する設計では、描画へ進む前の準備が負担になる。
四面体ケージ法は、前処理で高密度メッシュを小さな断片へ分け、各断片を静止状態の四面体へ割り当てる。三角形を収めた小さなBLASは静的なまま再利用し、実行時には低解像度のケージだけを変形させる。レイが変形後の四面体に入ると、そのレイを静止時の局所座標へ逆変換し、元の高密度形状と交差判定する。
この分離により、見た目の細かさを担う三角形数を維持しながら、アニメーションとBVH更新の費用をケージの四面体数に近づけられる。論文で草パッチを最大500個まで増やした比較では、ケージ解像度に応じて総処理時間が従来法より最大9倍短くなった。一方、描画処理だけを見れば同程度か少し遅い。利益の大半は三角形を速く描くことではなく、アニメーションとアクセラレーション構造の更新を減らした結果である。
80GBと300ms超は、従来法では実行以前に詰まることを示す
同じ25,000本の植生デモで、従来法のBVHメモリ最大80GBに対し、四面体ケージ法は約1.7GBだった。比率は約47.1分の1で、いずれもアプリケーション全体ではなくBVHだけのメモリ量である。
最大80GBは、16GBのGPUへ実際に格納して計測した総使用量ではなく、AMDが同じ場面を密な三角形BLASで表現した場合に必要になるBVH量として示した値だ。80GBは査読論文が全実験に使ったRX 9070 XTの16GB VRAMの5倍、1.7GBは同容量の10.6%に当たる。
時間は別の物差しで見る必要がある。60fpsの1フレーム予算は16.67msで、従来法のBVH更新300ms超は18フレーム分を上回る。一方、ケージ法の3.3msはフレーム予算の19.8%だ。ただし、どちらも1フレーム全体ではなくBVH更新だけの時間である。残る時間にはアニメーションの他処理、レイの走査、シェーディングなどが入る。AMDが示した60fps超はデモ全体の結果だが、9月17日の解説は総フレーム時間の内訳を公表していない。
5億個と5億8500万個は別のデモ
論文の複合シーンは表で5億8400万三角形、770.10MB、1フレーム12.43msとされ、9月17日の植生デモはLOD後約5億三角形、BVH 1.7GB、更新約3.3msとされる。対象と指標が異なるため、同じ測定としては比較できない。
| 項目 | 査読論文の複合シーン | 2026年9月17日の植生デモ |
|---|---|---|
| 場面 | 樹木、草パッチ、カエルの組み合わせ | 25,000本の植物 |
| アニメーション三角形 | 表3で5億8,400万個、図では約5億8,500万個 | LOD後約5億個、最高LODなら28億個 |
| ケージ規模 | 280万四面体 | 公表なし |
| メモリ | GPUメモリ770.10MB | BVHメモリ約1.7GB |
| 時間 | アニメーション0.35ms、構造更新9.66ms、描画2.42ms、合計12.43ms | 全BVH更新約3.3ms、総フレーム時間は公表なし |
| 光線条件 | 1画素当たり主光線1本と影用光線1本 | 主光線と影用光線 |
表の770.10MBはGPUメモリ、1.7GBはBVHメモリであり、同じ範囲の使用量ではない。12.43msはシェーディングとサンプリングを含む合計時間だが、3.3msはBVH更新だけである。比率を出すと、異なる指標を同じ物差しへ載せることになる。
論文本文は複合シーンを「約60fps」と表現する一方、表3の合計は12.43msと記録している。図の三角形数も5億8,400万個を約5億8,500万個へ丸めている。原典は12.43msと約60fpsの差を説明していないため、表の値から別のfps値を確定させることは避けたい。この論文はHolger Gruen、Carsten Benthin、Michael Kern、David McAllisterの共著で、DOIは10.1145/3820014。HPG 2026のWolfgang Straßer Best Paper Awardで同率3位を受賞した。
リアルタイム化と、隙間のない交差判定の交換条件
四面体で形状を分割する前処理は無料ではない。論文の各シーンでは、境界で三角形を切るため三角形数が元の1.3〜2.3倍、頂点数が1.4〜3.7倍に増えた。それでも小BLASをアニメーション中に作り直さずに済むため、動的な場面では前処理後の増加を上回る更新コスト削減が得られる場合がある。ケージを細かくすれば元の変形へ近づくが、メモリと更新時間は増える。
現行GPUでリアルタイムに動くハードウェアアクセラレーション版は、四面体の境界をわずかに重ねて亀裂を目立ちにくくするものの、境界に隙間が絶対に生じない交差判定を保証しない。論文には隙間のない交差判定を保証するソフトウェア実装もあるが、GPUメモリが2.3〜3.2倍、描画時間が19〜80倍になった。画質上の保証を強めると、リアルタイム性が崩れる。
手法が向くのは、草、樹木、葉、群衆など、接続関係を保ったまま滑らかに変形する対象である。十分に細かなケージを用意すれば、骨格に沿ったスキニングにも使える可能性がある。反対に、爆発や破壊、切断のように形状の接続関係が変わる動きには適さない。ケージより細かな布のしわや表情、急に変わる関節ウェイトも再現しにくい。剛体の大量配置なら、既存のインスタンシングの方が単純である。
ゲーム機能ではなく、サンプル開発中の研究
AMDはDXR向けのサンプルと、ヘッダーオンリーのC++ライブラリを開発中としている。現時点では、市販ゲームで選べるRadeon機能や、配布済みのゲームエンジン機能ではない。ケージの作成、変形品質の調整、亀裂の許容範囲を制作工程へ組み込めるかは、サンプル公開後に検証すべき課題として残る。
AMDは、四面体ケージをDirectX Raytracing(DXR)Part 2のClustered Geometryや、上位アクセラレーション構造(TLAS)を分割して更新するPartitioned TLASと併用できるとの見通しも示す。Clustered Geometryは動的ジオメトリのアクセラレーション構造を小さなクラスタ単位で扱い、再利用しやすくする設計だ。ただし、Microsoftの仕様ページv0.38は2026年9月8日時点でDXR Part 2を開発中と明記しており、晩夏のプレビューを見込む段階にある。
導入判断を左右するのは、GPUが何個の三角形を描けるかという一つの数字ではない。求める変形をどの粗さのケージで保てるか、境界の亀裂を許容できるか、前処理と実行時の削減が制作費まで含めて釣り合うかがそろって、初めて5億三角形のデモが実用技術へ近づく。