AlibabaのQwenチームが9月20日、画像生成と編集を統合した「Qwen-Image-2.1」の学習済み重みを公開した。画像生成部分を7Bパラメーターに抑えながら、自社ベンチマークではGoogleのNano Banana 2.0やOpenAIのGPT Image 1.5を上回る点数を示している。ただし、首位のGPT Image 2.5 Sunburstには差があり、重みの公開も自由な商用利用を意味しない。クローズドモデルの代わりになるかを考えるには、競合ごとの点差と、画像を作る一連の作業で何を自分で制御できるようになるかを分けて見る必要がある。
Nano Banana 2.0には僅差、GPT Image 2.5とは6.73点差
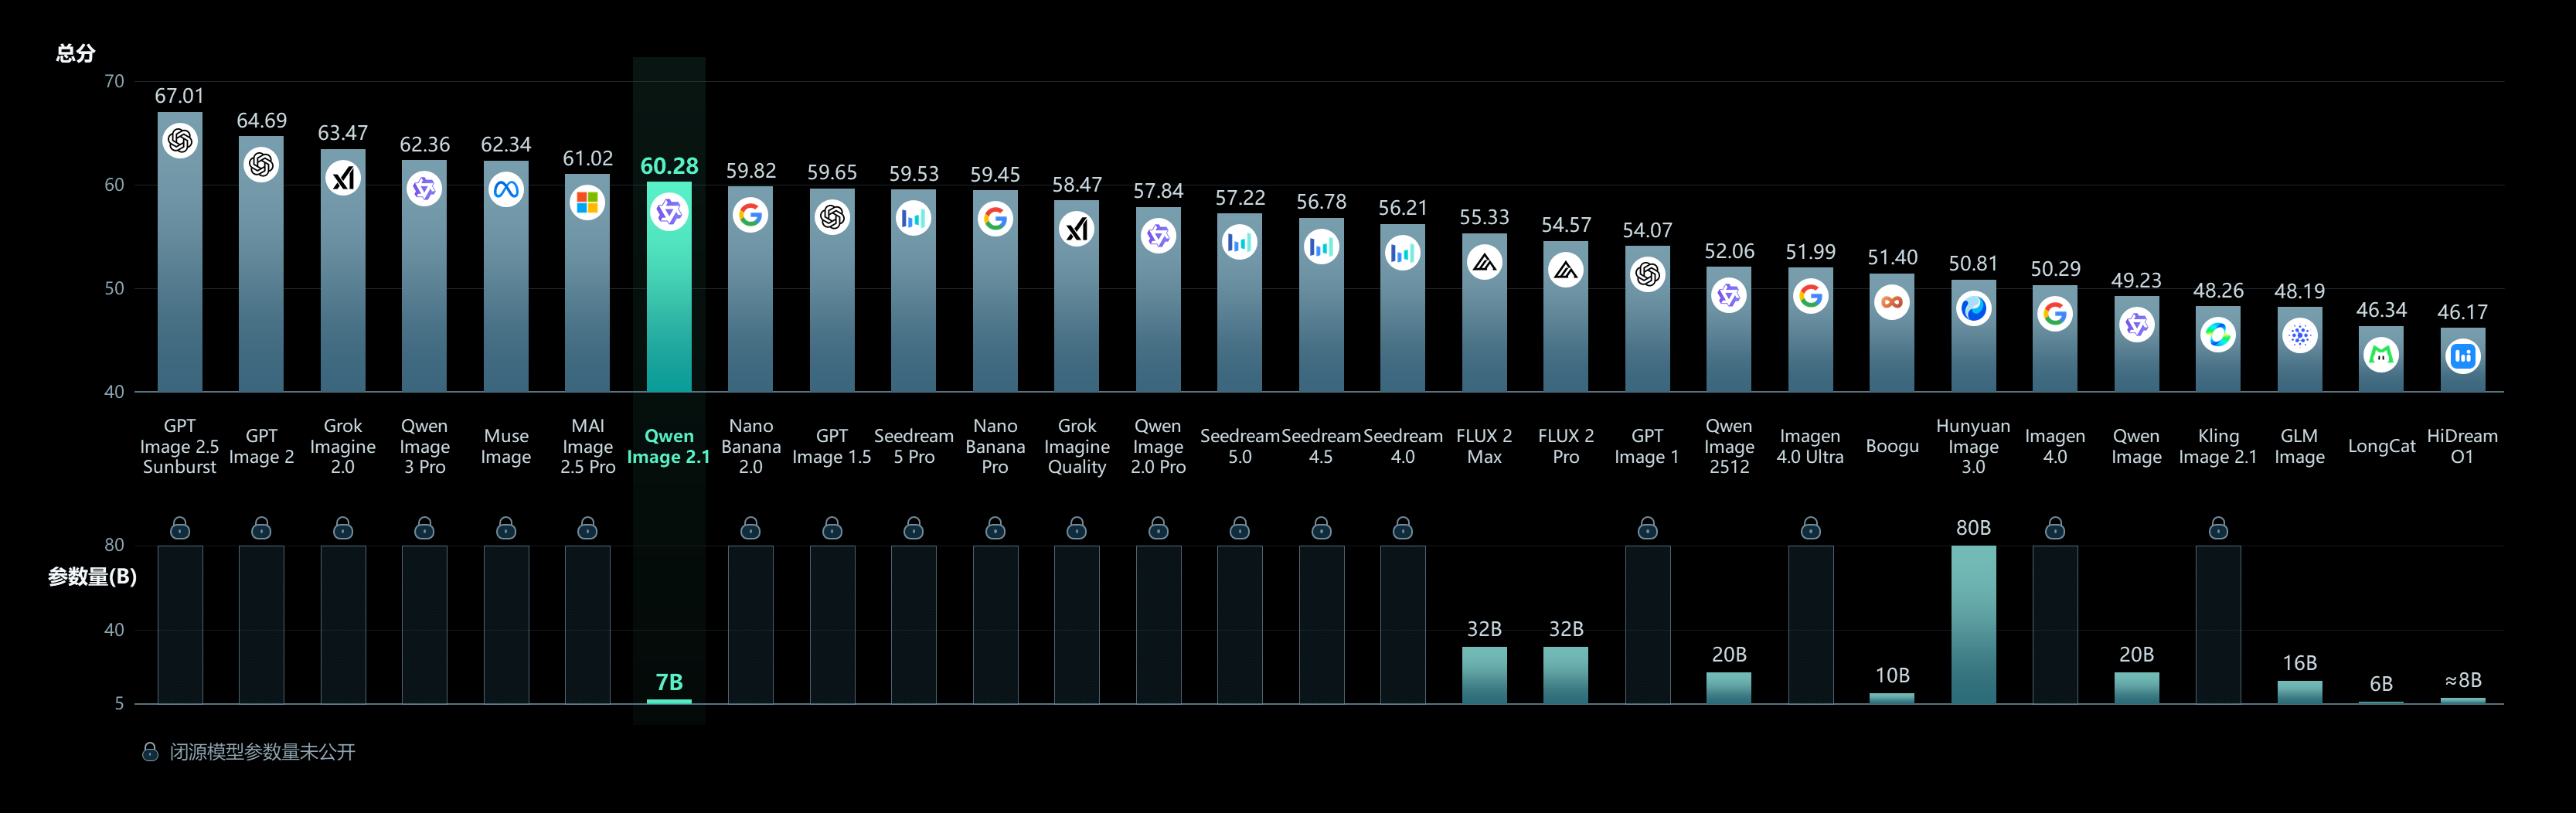
Qwenが公開した比較図では、Qwen-Image-2.1は29モデル中7番目に位置する。総合点は60.28。上にはOpenAIやxAIのモデルに加え、Qwen自身のQwen Image 3 Proも並ぶ。「クローズドモデルを超えた」という説明は、比較する相手によって意味が変わる。
表は9月20日の発表図から主要モデルを抜き出し、各モデルがQwen-Image-2.1を何点上回るか、または下回るかを示したものだ。モデル名は図の表記に合わせた。
| モデル | Qwen-Image-Bench総合点 | Qwen-Image-2.1との比較 |
|---|---|---|
| GPT Image 2.5 Sunburst | 67.01 | 6.73点上回る |
| GPT Image 2 | 64.69 | 4.41点上回る |
| Qwen Image 3 Pro | 62.36 | 2.08点上回る |
| MAI Image 2.5 Pro | 61.02 | 0.74点上回る |
| Qwen Image 2.1 | 60.28 | 比較基準 |
| Nano Banana 2.0 | 59.82 | 0.46点下回る |
| GPT Image 1.5 | 59.65 | 0.63点下回る |
| Seedream 5 Pro | 59.53 | 0.75点下回る |
| Nano Banana Pro | 59.45 | 0.83点下回る |
出典:Qwenの同一発表図。比較欄は各行のモデルを主語とし、Qwen-Image-2.1の60.28点との差を示す。独立した実測や勝率ではない。図には誤差範囲や反復回数が示されておらず、僅差の統計的な有意性は判断できない。
Qwen-Image-2.1の60.28点は、同じ発表図のNano Banana 2.0を0.46点上回る一方、GPT Image 2には4.41点、GPT Image 2.5 Sunburstには6.73点届かない。
つまり、Googleの一部モデルやGPT Image 1.5と点数が近い集団へ、ダウンロードして動かせる選択肢が入ってきたと読むのが妥当だ。首位を奪ったという結果ではないし、0.46点の差から、いつもNano Bananaより良い絵が出るとも言えない。
しかも、この比較は文章から画像を生成する評価である。Qwen-Image-2.1が新たに売りにする人物の保持や局所編集、透明画像の扱いやすさまで、この順位が証明したわけではない。生成で競り合えることと、編集作業を任せられることは、それぞれ確かめる必要がある。
60.28点が測っているもの
Qwen-Image-Benchは、絵の見栄えだけを採点する仕組みではない。公開データセットの説明によると、品質と美しさ、指示との一致に加え、現実世界の再現性と創作表現を評価する。全体は5つの大項目から23の下位能力、56の細かな項目へ分かれる。例えば文字が正しいか、指定した物の関係を描けるか、デザインとして成立しているかを区別する設計だ。
採点用のモデル「Q-Judger」は、各項目を不合格・合格・優秀に分け、それぞれ0点・60点・100点へ換算する。そこから下位能力、大項目へと平均し、各プロンプトで該当する大項目の平均を求める。最後に1,000問分を平均するため、60.28点を「60.28%の画像が成功した」「競合に60.28%の確率で勝つ」と読むことはできない。
この集計方法には実務的な狙いがある。Niantong Li氏らの設計論文は、不合格から合格への改善を、合格から優秀への改善より大きく扱うと説明している。前者は60点分、後者は40点分だ。破綻した画像を使える水準へ引き上げることを重く見る採点であり、単に「美しい絵」の人気投票とは性格が異なる。論文は2026年5月公開のプレプリントで、今回の2.1を独立に検証した研究ではない。
評価器にも出自がある。Q-Judgerの基盤はQwen3.6-27Bで、開発側は美術系の専門評価者80人が付けた13万件超の画像と指示のペアを学習に使ったと説明する。専門家との順位相関は0.92と報告されているが、これは今回の29モデルを80人が直接審査したという意味ではない。同じ開発陣の評価器だから結果が無効になるわけではないものの、別の評価器や人間による追試があって初めて、順位の頑健さを確かめられる。
さらに、公開READMEの詳細表は18モデルを載せた旧版で、中国語プロンプトから生成した画像を採点し、英語版の結果は後日公開すると記されている。今回の29モデルの発表図には、Qwen-Image-2.1の項目別点数や実行設定がない。旧表の中国語条件が新図にもそのまま当てはまるとは断定できず、日本語の文字描画でGoogleやOpenAIを上回ったとも言えない。
したがって、日本向けのポスターを作る人が知りたいのは、総合順位に加えて、日本語の誤字や文字配置をどの程度減らせるかである。人物写真の編集なら、顔や衣服を維持したまま指示した箇所だけを変えられるかが判断材料になる。総合点は試す候補を絞る助けにはなるが、用途ごとの成否を代わりに測ってはくれない。
7Bの外側にある計算
Qwenが示す7Bは、画像を生成するDiTという部分のパラメーター数である。公式実装の説明には、その外側に、文章と参照画像を理解するQwen3-VL 8Bが明記されている。画像を圧縮表現から復元するVAEも必要だ。7Bだけを見てモデル一式の大きさや必要なGPUメモリーを判断すると、実際の構成を見誤る。
発表図の読み方にも注意したい。下段では、クローズドモデルの棒が80Bの目盛り付近まで伸びているが、鍵の記号とともに「パラメーター数は未公開」と示されている。あの高さは実数ではない。Qwenの7Bをその棒で割って「10分の1以下の規模で同等品質」と結論づけることはできない。
一方、小型化と並んで説明されている計算の省略は具体的だ。画像生成では、ノイズを取り除く計算を繰り返す。その間、参照画像と編集指示は変わらないため、Qwen-Image-2.1は入力側の計算結果を最初のステップで保存し、後続で再利用する。画像が増えるほど、同じ入力を何度も処理し直す無駄を減らす意味が大きくなる。
既定の生成は40ステップだが、キャッシュが省くのは入力側の再計算であり、出力画像を更新する処理は続く。40倍速になる仕組みではない。クローズドモデルより速い、あるいは安いと判断するには、同じ解像度と参照枚数で処理時間や費用を測る必要がある。
もう一つ、公式は短い指示を詳しい記述に展開する補助モデルも推奨している。Qwen3.5-VL 9Bを微調整したもので、画像生成用と編集用が別に公開された。これは任意の前処理で、毎ステップ動かす必須部品ではないが、利用者が入力した一文と、画像モデルへ実際に渡す文章は変わり得る。競合と同じ指示を入力する試験でも、書き換えを有効にしたかは記録すべき条件になる。今回の発表図からは、その設定を確認できない。
重みが手に入る意義は、こうした構成を利用者側で調べ、条件を変えて確かめられる点にある。「7Bだから軽い」で話を止めるより、どこを量子化し、何をGPUに置き、指示を書き換えるかまで選べることの方が、導入判断には役立つ。
透明画像と10枚参照は、競合との差になるか
Qwen-Image-2.1は、通常の画像と、透明度を持つRGBA画像の生成・編集を同じモデルで扱う。Qwenが2025年12月に専用モデルQwen-Image-Layeredで導入した透明画像の機能を、今回、生成と編集の両方を担うモデルへまとめた。透明な背景を残したまま表情を変える、透明レイヤー内の文字を直す、写真から被写体を取り出す、といった例を公式が示している。
ただし、透明背景や複数画像の参照そのものは、クローズドモデルにもある。9月21日時点の各社公式資料を並べると、機能の有無だけでは差を説明しきれない。
| 比較する機能 | Qwen-Image-2.1 | クローズドモデルの公式仕様 | 比較から言えること |
|---|---|---|---|
| 透明背景 | RGBAを生成し、透明画像を直接編集 | OpenAIのGPT Image 2.5 Sunburstは透明背景を出力可能。GPT Image 2もプレビューで対応 | 透明背景の出力はQwenだけの機能ではない |
| 複数の参照画像 | 最大10枚 | GoogleのNano Banana 2は最大14枚。高い忠実度で扱う物体10枚、人物の一貫性を保つ4枚という内訳を示す | 枚数だけでQwenの優位は主張できない |
| 出力解像度 | ネイティブ2K。正方形の既定値は2,048×2,048 | GoogleはNano Banana 2で最大4Kを案内 | 2K対応と画質の優劣は別に評価する必要がある |
出典:Qwen公式実装、OpenAI API仕様、Google画像生成ガイド。対応機能の比較であり、同条件の画質試験ではない。GoogleのAPI上の名称はNano Banana 2(Gemini 3.1 Flash Image)で、Qwenの比較図はNano Banana 2.0と表記している。
Qwenを選ぶ理由が生まれるのは、これらの作業を自前の環境で組み合わせたい場合だろう。例えば透明な素材を作ってから別の背景へ配置し、人物や製品の特徴を保ちながら修正する。一連の処理を手元で検証できれば、得意な工程だけを担当させる使い方も考えられる。もっとも、公式の作例は成功例であり、細部を保持できる頻度や、修正を重ねたときの劣化は別途測る必要がある。
商用導入には、さらに明確な条件がある。Qwen Research License Agreementは、非商用の範囲を研究・評価目的に限り、商用利用には別のライセンス取得を求めている。重みを無料で取得できても、そのまま業務用サービスを運営できるわけではない。公表点が競合より高くても、契約条件や運用費を含めて安くなるかはまだ判断できない。
Qwen-Image-2.1が開いたのは、有力なクラウド画像モデルに近い公表スコアを持つモデルを、自分の入力と評価基準で試せる機会である。日本語の文字や製品の細部を保つ試験で必要な品質を満たし、商用許諾と運用費が折り合えば、制作工程の一部をクラウドから手元へ移す具体的な候補になる。