


Moth Quantumは2026年11月16日、IBMの120量子ビット装置「Phoenix」全体を使い、カラー画像を表す1,568個の実数を符号化して読み戻す方式「Tessa」を発表した。28×28画素の画像について、各画素の明るさと色相をそれぞれ数値化し、量子ビットに符号化した実験である。
Tessaは、量子ビット間の物理的な接続を利用することで、多数の数値を量子プロセッサに入力できるようにした。ただし、符号化できる値の数と、それらを正確に読み戻せるかどうかは別の問題である。Tessaでは同じ量子回路の準備と測定を繰り返し、得られた確率から個々の値を推定する。符号化する値が増えるほど、読み出しに必要な測定回数も重要になる。
量子ビットの接続構造を活用するTessa
研究成果は、Moth QuantumのDaniel Bultrini氏が執筆した論文「Tessa: Encoding Classical Data Across an Entire Quantum Processor」にまとめられている。11月13日に公開されたarXiv:2611.18440v1で、現時点では査読前のプレプリントである。
Tessaは量子ビットを、数値を保持するデータ用と、その数値の位置を指定するアドレス用に分ける。各データ量子ビットは、隣接するアドレス量子ビットの状態の組み合わせに応じて回転し、その回転角に数値を符号化する。例えば、隣接するアドレス量子ビットが4個あれば、状態の組み合わせは2の4乗で16通りとなり、1個のデータ量子ビットに16個の値を符号化できる。
従来のQPIXLは、共通のアドレス量子ビット群を1個のデータ量子ビットに接続し、QCrankはそのアドレス群を複数のデータ量子ビットで共有する方式だった。これに対しTessaは、各データ量子ビットの制御に使うアドレス量子ビットを隣接するものに限定し、その一部を近隣のデータ量子ビット同士で共有する。これにより、離れた量子ビット間で状態を移動させるSWAPゲートや追加の補助量子ビットを使わずに、実際の配線に沿って多数の値を符号化できる。
実験には、正方格子状に量子ビットを配置した120量子ビットのPhoenixと、重六角格子構造を持つ156量子ビットのFezが使われた。1画素につき1値を符号化する実験では、Phoenixが784値、Fezが441値を扱った。さらに、明るさを極角、色相を位相として1画素に2値を符号化する方式では、それぞれ1,568値と882値に増えた。
Bultrini氏が比較対象とした先行研究のQCrank実験では、12量子ビットを使って128値を符号化し、読み戻していた。ただし、この比較は「任意の実数列を実際の量子プロセッサに書き込み、個々の値を読み戻す」という条件に限られる。画像を入力して分類結果だけを返す研究や、学習済みの近似表現から画像を復元する研究とは条件が異なるため、値の個数だけで復元品質や処理速度の優劣を判断することはできない。
測定回数が左右するデータの復元精度
多数の値をアドレス量子ビットの状態の組み合わせに符号化すると、測定結果はそれぞれの組み合わせに振り分けられる。隣接するアドレス量子ビットが4個の場合、8,192回の測定結果は16通りの状態に分かれるため、1値当たりの標本数は平均約512回となる。論文2.3節で示された理想的な標本数の式 (N/2^m) に、(N=8,192)、(m=4) を代入すると、8,192÷16=512となる。
Bultrini氏は、Tessaの読み出し負荷は主に測定回数によって決まると説明している。角度推定に伴う標本誤差は、主要項が (2^{m/2}/\sqrt{N}) に比例する。同じアドレス量子ビット数で誤差を半分にするには測定回数を約4倍に、アドレス量子ビットを1個増やして精度を維持するには約2倍にする必要がある。ただし、これは理想的な標本誤差についての関係であり、実機のノイズや補正処理を含む総誤差を表すものではない。
9月26日に実施された主要な画像実験では、各測定基底につき8,192回の測定が行われた。1値符号化ではZ基底のみを使い、総測定回数は8,192回だった。一方、2値符号化ではZ基底とX基底を使って明るさと色相を推定するため、合計16,384回の測定を必要とした。
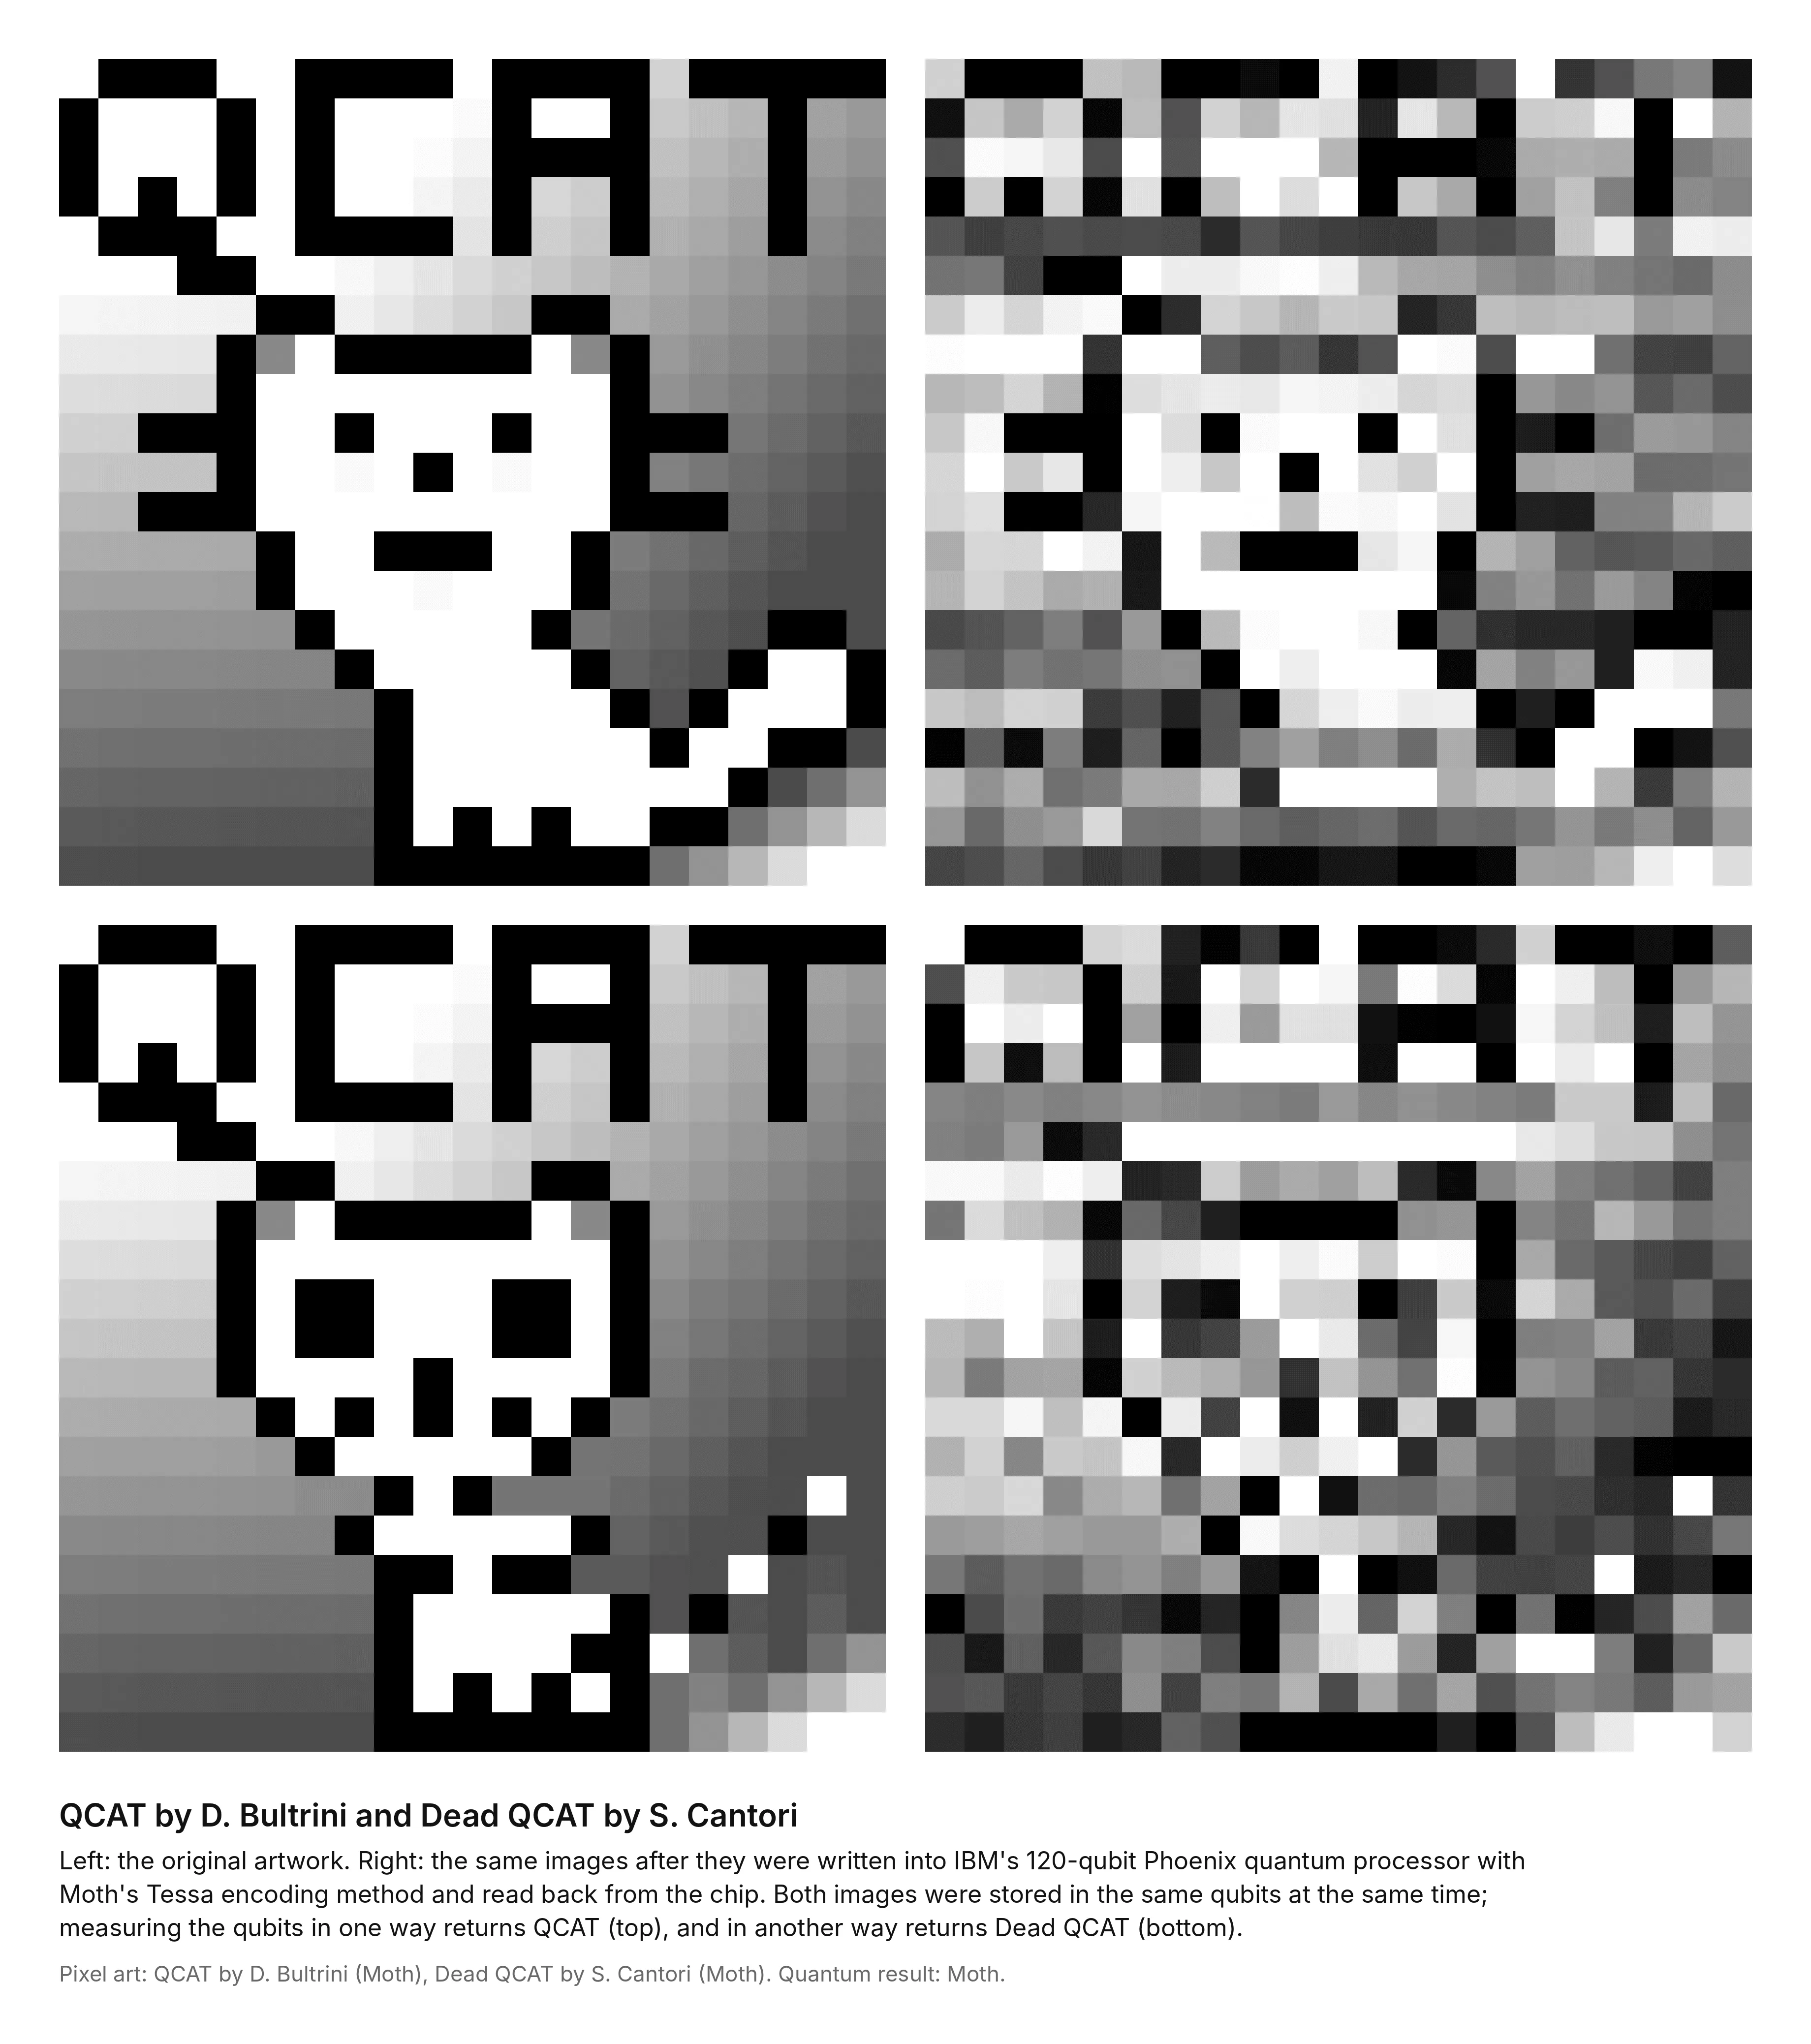
論文表1に掲載された、同じQCAT画像を使った実験結果は以下の通りである。
| 条件 | 値数 | 平均絶対誤差(未補正) | 平均絶対誤差(補正後) | 相関係数 |
|---|---|---|---|---|
| Phoenix実機、1値符号化 | 784 | 0.130 | 0.075 | 0.96 |
| 局所ノイズシミュレーション、1値符号化 | 784 | 0.104 | 0.059 | 0.97 |
| Phoenix実機、2値符号化 | 1,568 | 0.152 | 0.154 | 0.69 |
| 局所ノイズシミュレーション、2値符号化 | 1,568 | 0.059 | 0.048 | 0.94 |
注:平均絶対誤差は0〜1の尺度で評価した値。2値符号化の誤差と相関係数は明るさについての結果であり、色相の誤差は含まない。各測定基底の測定回数は8,192回。補正には元画像の平均値と標準偏差を使用した。
平均絶対誤差は元の数値と復元値のずれを表し、相関係数は両者の値の対応関係を示す。相関係数0.96は、画素の96%が完全に一致したという意味ではない。今回の1,568値の実機実験では、明るさの相関係数は0.69だった。
補正方法にも注意が必要だ。実験で使われたダイナミックレンジ補正は、元画像の平均値と標準偏差を利用し、読み戻した値の分布を調整する古典的な処理である。量子回路の誤り緩和は使われていない。この補正によって、実機の1値符号化では平均絶対誤差が0.130から0.075へ改善したが、2値符号化では0.152から0.154となり、わずかに悪化した。
シミュレーションでは、各データ量子ビットと隣接するアドレス量子ビットからなる部分回路を計算し、実機の校正データに基づくノイズを加えている。この方法では、部分回路の外側にある量子ビットとの干渉などが省略される。特に2値符号化ではシミュレーションと実機の誤差に大きな差が生じており、著者も局所ノイズモデルの限界を指摘している。ただし、この結果だけでは個々の誤差要因がどの程度影響したかまでは特定できない。
DNAとタンパク質で大きく異なる復元精度
画像では数値が多少ずれても視覚的な特徴が残る場合があるが、DNAやタンパク質の配列では小さな誤差が別の記号への取り違えにつながる。10月16日に実施された生体配列の実験では、Phoenixを使って各測定基底につき32,768回の測定を行った。DNAやRNAは4種類の塩基、タンパク質は20種類のアミノ酸を、それぞれ既知の記号として扱っている。
実験で使われた球面配置方式は、量子ビットの状態を表すブロッホ球上に候補となる記号を配置し、Z、X、Yの3つの測定基底から得られた結果に最も近い候補を選ぶ方式である。1つの位置に1記号を符号化する場合は4または20状態、2記号の場合は16または400状態を区別する必要がある。候補の数が増えて状態間の距離が小さくなるほど、測定誤差によって別の記号を選ぶ可能性が高まる。
論文表8によると、ヒトのミトコンドリア遺伝子MT-CO3に含まれるDNA784塩基を、1位置につき1記号の方式で符号化した実験では、実機での記号一致率は未補正で92.1%、最良の補正後で92.3%だった。一方、SUR1アイソフォーム2のタンパク質1,582残基を1位置につき2記号で符号化した場合、一致率は21.0%から22.6%にとどまった。ここでいう最良の補正結果は、元の正しい配列と照合し、一致率が最も高くなる補正方法を選んだ値である。
この精度の差は、配列の長さだけでは説明できない。同じ1,582文字のPOLG2メッセンジャーRNAを2記号ずつ符号化した実験では、記号一致率は未補正の83.8%から補正後の84.3%となった。SUR1と配列長や符号化方法をそろえても、4種類の塩基と20種類のアミノ酸では区別する候補の数が大きく異なる。ただし、これらの実験は記号の種類や配列内容も異なるため、特定の条件だけが精度に与える影響を切り分けた比較ではない。
SUR1の球面配置方式については、無雑音シミュレーションで100.0%の一致率が得られた。ノイズを加えたシミュレーションでも未補正63.7%、最良補正後69.5%だったが、実機では21.0%から22.6%にとどまり、大きな差が生じた。著者は、単純化したノイズモデルでは実機の誤差を十分に再現できていない可能性などを指摘している。なお、この実験で評価したのは配列データを正確に復元できるかどうかであり、DNAやタンパク質の生物学的な機能を調べたものではない。
次に問われるのは計算全体での有用性
論文の付録Dでは、符号化したすべての数値を読み戻す記憶装置としてTessaを利用する場合、繰り返し測定の負担が大きく、古典的なメモリーの方が優位になると説明している。想定される用途は、符号化した量子状態に対して処理を行い、最後に少量の結果だけを読み出す計算である。符号化できる値の個数だけでなく、目的の計算結果を得るまでの処理負荷を評価する必要がある。
検証に必要な資料の一部はすでに公開されている。Moth QuantumのGitHubリポジトリには、Tessaの実装コード、画像や生体配列の実機測定データ、量子回路、論文の図表を再生成するノートブックが収録されている。保存されたデータの再解析にはIBMのアカウントが不要であり、論文の数値を検証できる。ただし、既存データを再解析することと、別の量子プロセッサで同じ結果を再現することは異なる。現時点で確認できた公開情報からは、独立した実機追試の結果は見つかっていない。
実用性を判断するには、元の画像や配列が分からない未知の入力に対しても適用できる補正方法を確立し、実際の量子計算で目的の結果を得られるかを調べる必要がある。今回の実験では、元データを使った補正や補正方法の選択が行われており、局所ノイズモデルと実機の結果にも差がある。こうした条件を整理したうえで、データの符号化から計算結果の読み出しまでに必要な量子ゲート、測定回数、古典処理を含めて評価することが、Tessaの用途を見極めるための次の課題となる。


