Perplexityは2026年9月14日、ローカルAIエージェント「Portable Computer」をWindows版Perplexityアプリへ追加した。従来のNVIDIA DGX SparkとLinux搭載RTX PCに加え、対応するGeForce RTX搭載Windows PC、RTX PROワークステーションへ利用環境を広げた。
ただし、ここでいうWindows PCは広く普及するCopilot+ PCや、一般的なゲーミングPCを意味しない。オンデバイス推論には24GB以上のVRAMが必要で、利用者は個人・企業向けのProまたはMax契約にも加入している必要がある。Windows対応は確かに裾野を広げるが、現時点では最上位GPUを既に持つ開発者、クリエイター、企業のワークステーション利用者へ寄った拡張である。
Linux搭載RTX PCからWindowsへ利用環境を拡大
Portable Computerは、複数段階の仕事を計画して実行するPerplexity Computerを、利用者の機械で動かすローカルファースト版である。Perplexityの説明では、Windows版は既存アプリのモデル選択欄からローカルモデルを選び、必要なモデルをダウンロードして使う。NVIDIAは具体例として、Perplexity Computer向けに事後学習され、RTX GPU向けに最適化されたQwen 3.8 27Bを挙げている。
NVIDIAによれば、今回のWindows版は、既に対応していたDGX SparkとLinux搭載RTX PCに続く提供範囲の拡張である。条件を満たすWindows機で既存のPerplexityアプリから使えるため、Linux環境を用意せずに導入できるようになった。もっとも、OSの選択肢が増えたことと、普通のPCで動くことは同義ではない。
モデルだけではない、ローカルに置かれる実行系
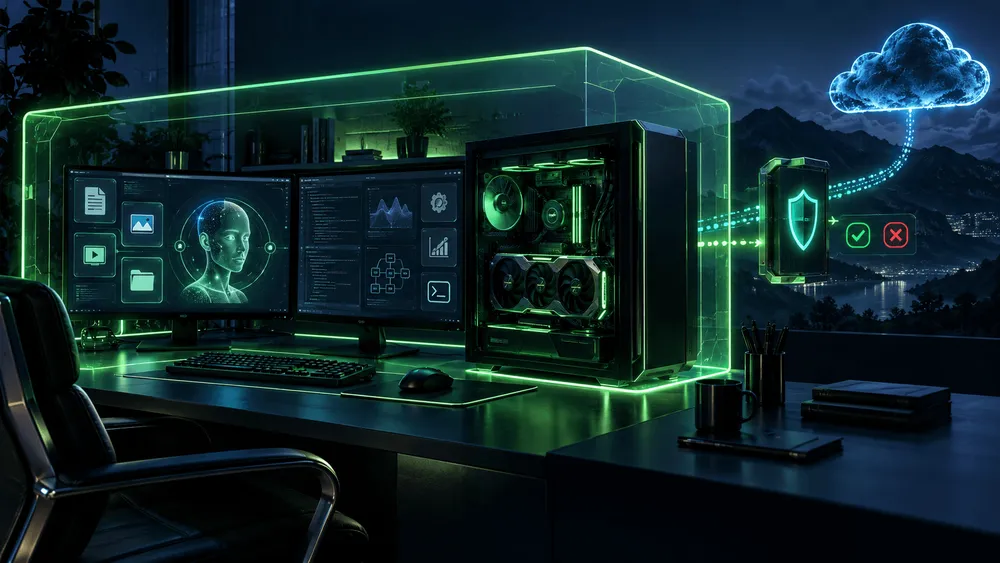
この製品を単なる「ローカルLLMアプリ」と見ると核心を外す。Perplexityによれば、端末内で動くのはモデルだけではない。プランナーが作業を分解し、ツールルーターが使う機能を選ぶ。決定論的なオーケストレーターとagent harness(エージェント実行基盤)は、承認済みのツール呼び出しを隔離サンドボックスで実行する。さらに、スケジューラーと永続タスクキューが定期処理と状態を保ち、ローカル検索索引が端末内の情報を探す。
この組み合わせにより、長時間の仕事を「一度質問して答えを得る」処理から切り離せる。許可したフォルダの請求書を毎朝照合する、ローカルのコードベースを参照してプルリクエストを分類する、といった定期処理には、モデルの推論能力だけでなく、状態を保つキュー、索引、ファイル権限、ツール実行環境が必要になる。ローカルで完了した処理はComputerクレジットを消費しないため、反復回数の多い仕事ではクラウド従量課金を避けられる。代わりに利用者がGPUの購入費、電力、保守を負担する構造になる。
24GBが線を引く、対応GeForceは最上位に偏る
NVIDIAの標準仕様で確認した5機種のうち、24GB以上を満たすGeForceはRTX 3090、3090 Ti、4090、5090であり、RTX 5080(16GB)は対象外となる。
| GPU | NVIDIA標準VRAM | 24GB要件 |
|---|---|---|
| GeForce RTX 5090 | 32GB | 満たす |
| GeForce RTX 5080 | 16GB | 満たさない |
| GeForce RTX 4090 | 24GB | 満たす |
| GeForce RTX 3090 Ti | 24GB | 満たす |
| GeForce RTX 3090 | 24GB | 満たす |
この表は2026年9月16日時点のNVIDIA標準仕様を、Portable Computerの24GB要件と比較したものだ。値はRTX 5090、RTX 5080、RTX 3090 Family、RTX 4090はNVIDIA Ada GPU ArchitectureのAppendix Aで確認した。
この比較が示すのは、製品世代の新しさよりメモリー容量が強い足切りになることである。現行世代の上位GPUであるRTX 5080でも外れ、2世代前のRTX 3090は残る。Tensor Core世代や公称AI性能だけを見ても対応可否は判断できない。なお、これは公式仕様を確認した5機種の分類で、GeForce全製品やRTX PRO、OEM独自構成を網羅した一覧ではない。VRAMを満たしても、OS、ドライバー、ストレージなど別条件まで保証するものでもない。
「ローカル」は完全オフラインと同義ではない
Portable Computerはローカル処理を既定にするが、外部世界を遮断する製品ではない。Perplexity Search、Gmail、Outlook、Slack、GitHubなどの接続サービス、複数のクラウド上のフロンティアモデルを同じ作業へ組み込める。ローカルMCPサーバーを介してデスクトップアプリを操作する構成も用意する。
PerplexityとNVIDIAは、端末外へ情報を送る必要が生じた場合、処理前に利用者へ許可を求めると説明する。したがってプライバシー上の価値は「何も外へ出ない」という絶対条件ではなく、ローカルのファイル処理と、検索・コネクター・クラウド助言の境界を利用者が選べる点にある。企業導入では、許可画面だけでなく、どの断片をどのサービスへ送ったかを管理者が監査できるか、接続先にどの保持規則が適用されるかが次の確認点になる。今回の発表は、その細粒度な管理仕様までは示していない。
DGX Sparkの85.4%はWindows性能表ではない
Perplexityはローカル実行の有効性を示すため、日常的な知識労働を模した社内のLocal Knowledge Work Benchを公開した。53タスクを各3回、DGX Spark上で実行した結果、ComputerとQwen 3.8 27Bの組み合わせは82.6%、汎用実行基盤のPiは77.6%、Hermesは74.0%だった。Qwenを追加学習したPPLX 27Bでは85.4%に上がったという。
一方、速度ではPiが平均176秒、ComputerとQwenが218秒、PPLX 27Bが250秒で、最高スコアの構成が最速ではない。消費トークンもComputerとQwenの520,000に対し、PPLX 27Bは678,000だった。さらにPerplexityは、公称260,000トークンの文脈を持つQwen 3.8 27Bでも、経験的には100,000トークンを超えると苦しくなると認めている。そのため基礎プロンプトと基本ツールを小さく保ち、必要な能力だけをskillsとして読み込む設計を採った。
これらはモデル単体ではなく、モデルと実行基盤の共同設計が成績を左右することを示す材料にはなる。ただし、Perplexity自身が設計・測定した小規模な社内ベンチマークであり、独立再現ではない。測定機もDGX Sparkで、24GBのGeForceを搭載したWindows PCとはメモリー構成も実行環境も異なる。Windows版の精度、所要時間、消費電力、実VRAM使用量は公表されておらず、85.4%をWindows版の性能保証として読むことはできない。
反復業務で問われるWindows実測と送信管理
請求書の照合やコードベースの分類を毎日任せるには、Windows実機での所要時間、消費電力、実VRAM使用量が導入費用を左右する。さらに、検索やコネクターを併用するたび、どの情報を端末外へ送ったかを利用者と管理者が追跡できなければ、ローカル処理を選ぶ利点を運用で確かめにくい。いずれも今回の発表では十分に示されていない。
24GB未満への対応も発表されておらず、量子化やモデル小型化で要件が下がるかは未確定である。Windows対応を広い普及につなげる条件は、最上位GPUで動くことの確認ではなく、反復業務の実測と送信管理を公開し、対象機の範囲をどこまで広げられるかにある。