TypeSafe AIは9月15日、ソフトウェアが直接利用できる判断を返す「System One」モデルと、その最初の公開モデル「Jev」の早期アクセスを発表した。Jevは自由な文章を生成せず、あらかじめ定めた選択肢や評価尺度に対する答えと確率を返す。入力100万トークン当たり0.042ドル、出力は課金なしという価格に加え、同社の業務処理評価では193.6倍の高速化をうたう。ただし、比較対象は特定の判断タスクであり、汎用的な知能が同等という意味ではない。文章生成を手放したことで何が変わり、どこまで自動化を任せられるのかが、Jevを理解する出発点になる。
自由な文章を捨て、判断をソフトウェアへ返す
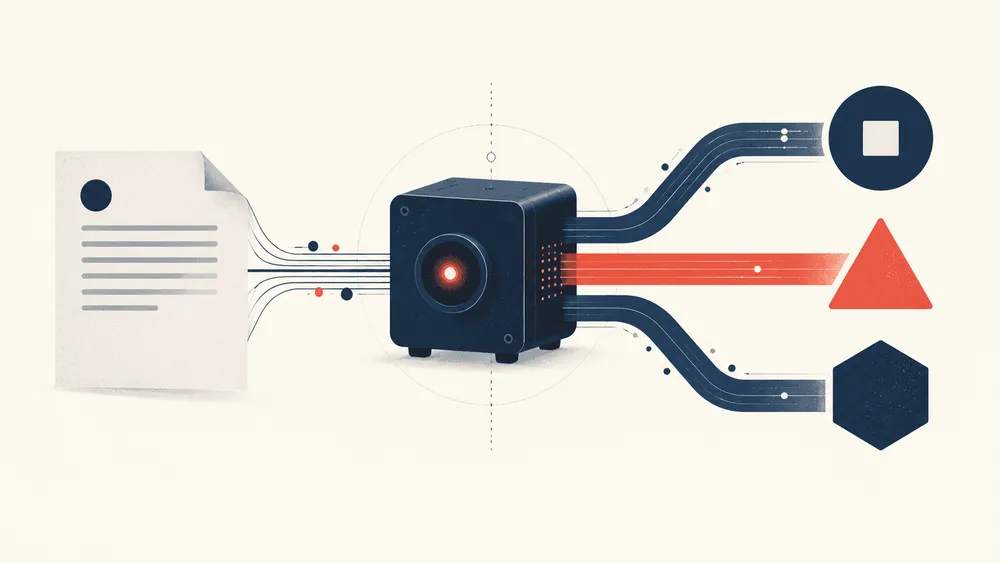
Jevへの入力は、判断材料をまとめたstateと、その材料について尋ねるquestionsから成る。問い合わせの文章だけでもよいし、会話履歴に注文情報や社内規定を加えたデータでもよい。同じ材料に対して複数の問いを送り、それぞれを独立に評価する。自然言語の理解は使うが、返答を会話文へ仕立てる工程を省く設計だ。
開発者が使う質問形式は、公式文書で次のように定義されている。
- Choiceは、用意した候補から選ぶ。「担当部署は請求、技術、アカウントのどれか」といった問いに、選択結果と全候補の確率、信頼度を返す。候補数の上限は255個だ。
- Scoreは、言葉で説明した段階に沿って評価する。段階数は2〜10で、各段階の確率と、その番号の加重平均を返す。
- Noulは、「返金を求めているか」のような問いに、答えが「はい」である確率を0〜1で返す。別の信頼度フィールドは持たない。
Scoreの値は、モデルが自由に考えた点数とは少し違う。たとえば障害の深刻さを0、1、2の段階で定義し、それぞれの確率が0、0.70、0.30なら、結果は「0×0+1×0.70+2×0.30=1.30」となる。利用者が尺度を決め、その尺度上の位置を確率から計算する。顧客の何割に障害が起きたかを示す数字ではない。
この設計なら、「返金を処理せよ」という大きな指示を丸ごとAIへ渡す必要はない。返金の要求があるか、二重請求を示す説明があるか、規定に合うかを分けて尋ね、回答をコードで組み合わせればよい。金額の計算や処理を実行する条件は、通常のプログラムに置ける。AIの判断をソフトウェアの部品として使うのが、TypeSafeの狙いである。
System Oneという名前は、Daniel Kahnemanの速い直感的な思考と、時間をかけた熟考の区分から取られた。ただし、人間の脳の仕組みを再現したという主張ではない。公式文書も、一度に長い推論を求めるより、適切な情報を与えた人が短時間で判断できる程度の問いへ分解するよう勧めている。
構造化出力に対応するLLMと何が違うのか
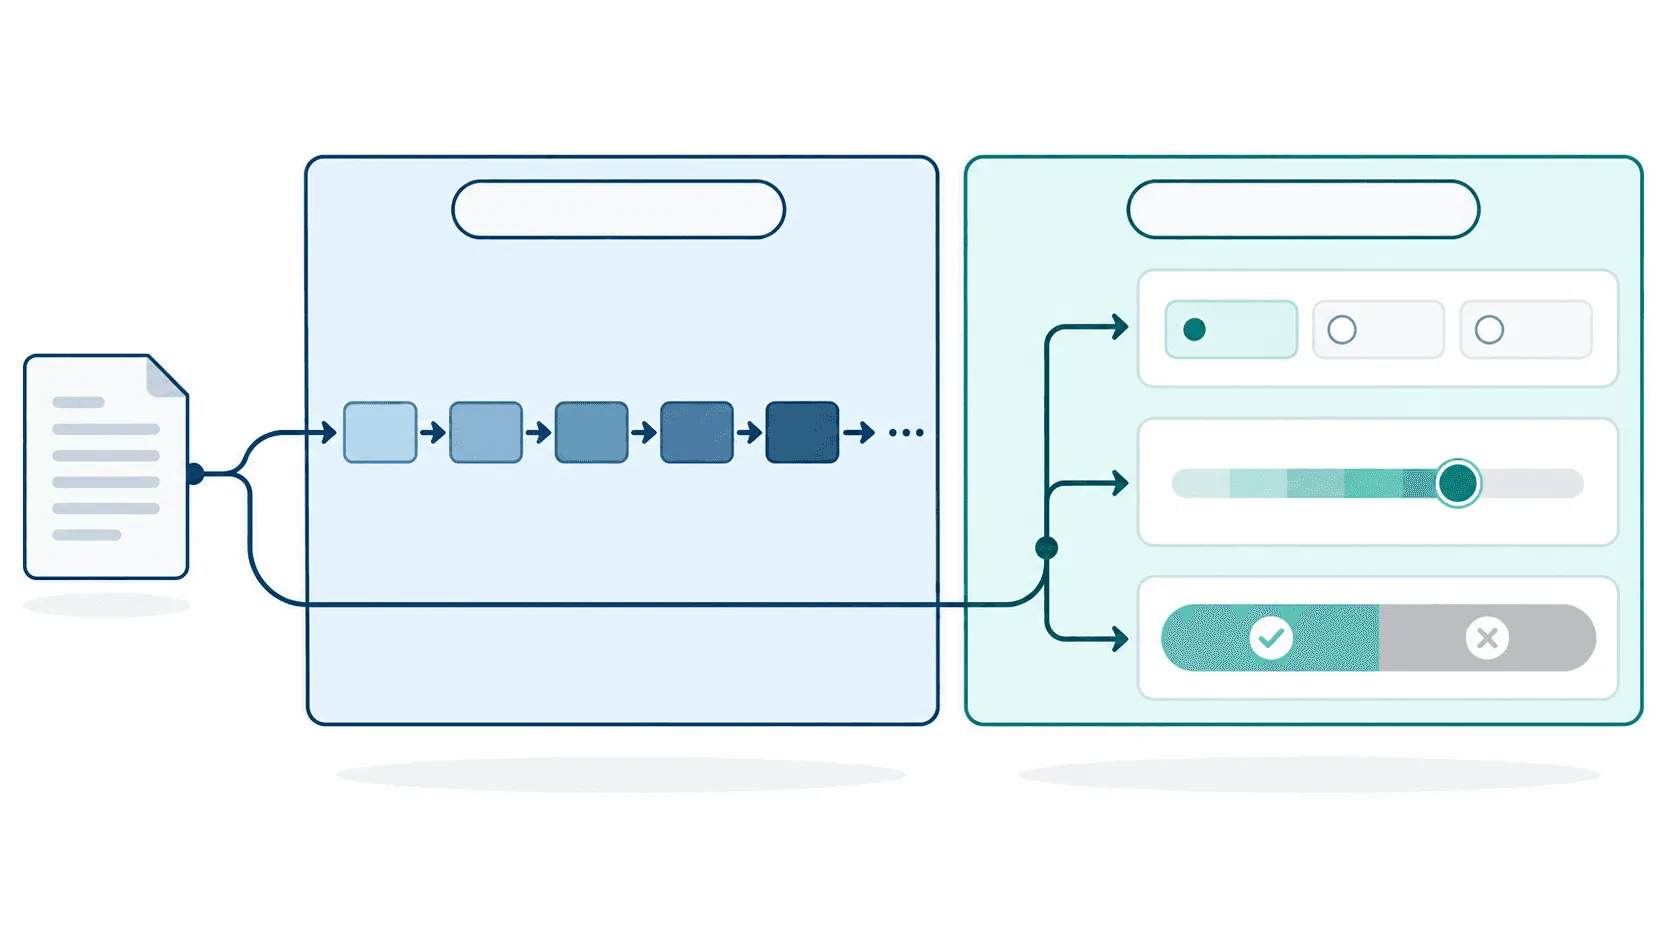
既存の大規模言語モデル(LLM)にも、出力の形を厳密に制限する仕組みはある。OpenAIが2024年8月に発表したStructured Outputsは、開発者が指定したJSON Schemaに合わせ、次に出せるトークンを絞る。拒否や生成の途中終了などを除く対応条件では、所定の形式に合う出力を保証する。単に「JSONで答えて」と頼む方法とは異なる。
したがって、Jevの違いを「LLMは文章しか返せず、Jevだけが形式を守る」と説明すると、本質を取り違える。比較すべきなのは、制約を付けて文章を生成する仕組みと、制約された判断を返すことに特化した仕組みである。
| 比較する点 | 主に自己回帰型のLLM | Jev / System One |
|---|---|---|
| 出力の作り方 | それまでの出力を踏まえ、次のトークンを順に生成する | 同社によれば、複数の問いへの答えと確率を並列に返す |
| 形式の制約 | 対応モデル・APIでは、生成候補を制限してスキーマへの適合を保証できる | Choice、Score、Noulで可能な答えを事前に定義する |
| 自由記述 | 文章やコード、説明を生成できる | 返信文やコード、推論過程の説明を生成しない |
| 複雑な仕事の組み立て | モデルの推論とツール、コードを組み合わせる | 狭い判断へ分解し、結果の組み合わせや処理の分岐をコードで決める |
表のLLM側はOpenAIの制約付き生成の説明、Jev側はTypeSafeの発表とモデル仕様に基づく。全言語モデルを同じ方式に分類したものではなく、自由記述の能力と判断専用の設計を比べたものだ。
自己回帰型では、確率分布をJSONに書き出す場合も、値や区切りを順番に生成する。Jevはその自由度を手放し、複数の答えを並列に扱うことで待ち時間を縮めるという。多数の判断をまとめて尋ねられるため、個別に呼び出す回数も減らせる。ただし、質問の追加には入力トークンがかかり、量を増やしても費用まで一定になるわけではない。
一方、内部のモデル構造には公開情報の限界がある。TypeSafeは新しいアーキテクチャと並列サンプラーを開発したと説明し、Jevを「小さなLLM」とは位置づけていない。しかし、発表と技術文書からはパラメータ数や層構成を確認できない。Transformerを使っていない、あるいは全処理が単一の演算で終わる、といった断定はできない。現時点で詳しく比較できるのは、公開された入出力と処理方式、学習の目標である。
RLCDは「正解」と同時に不確実さを学ばせる
TypeSafeの創業者Diogo Almeidaは、2022年のInstructGPT論文の共著者だ。同研究は人間が書いた回答例でモデルを調整し、さらに人間が付けた回答の順位を用いて学習する方法を示した。人間のフィードバックによる強化学習、RLHFである。指示に従う会話モデルの発展に関わった研究者が、今回はソフトウェア向けの判断を学習目標に据えた。
RLHFでは、人がどの回答を好むかが学習を導く。これに対し、検証可能な報酬を使うRLVRは、正しさをプログラムで確かめられる課題を利用する。DeepSeek-R1の論文にある例なら、数学の答えを照合したり、コードをテストケースで確かめたりして報酬を与える。両者は学習の手掛かりが違う。
TypeSafeが発表したRLCDは、Reinforcement Learning for Calibrated Decisionsの略称で、判断と確率校正のための強化学習を意味する。同社の説明では、出力する確率を結果に照らして最適化し、不確実さを反映できるようにする。正しそうな答えを返すだけでなく、その答えをどれほど確かだと見積もるかも学習の対象に置く。
確率校正の意味は、天気予報を思い浮かべると分かりやすい。ある事象に「80%」を付けた予測を多数集めたとき、実際に約80%でその事象が起きるなら、予測と結果の頻度が整っている。残りのケースで外れることも、80%という予測と矛盾しない。一件の答えを必ず当てることとは別の性質だ。
校正そのものは、Jevで初めて生まれた考え方ではない。GuoらのICML 2017論文は、ニューラルネットワークの予測確率が実際の正しさとずれる問題を調べ、画像・文書分類で出力を事後調整する方法を評価している。TypeSafeの提案は、判断を返すモデルの学習目標に校正を組み込むというものだ。
ただし、RLCDの具体的な報酬式や損失関数、訓練規模は、確認できた公開資料には示されていない。狙いの違いは説明できても、その学習法がどの条件で既存方式より優れるかまでは検証できない。RLHFを使ったモデルには確率を扱えない、RLVRなら必ず遅くなる、という区分でもない。TypeSafeの学習方針と、それを裏づける性能評価は分けて読む必要がある。
「確率」と「信頼度」は同じ数字ではない
JevのChoiceとScoreには、候補ごとの確率を表すprobabilitiesと、信頼度を表すconfidenceがある。後者は、確率分布が一つの候補へどの程度集中しているかを、0〜1の数値へまとめた統計量だ。選ばれた候補の確率を、そのまま別名で返しているわけではない。
TypeSafeの公開例では、Choiceの最大確率0.60に対してconfidenceは0.39であり、confidenceをそのまま正答確率とは読めない。
これは2026年9月16日に確認したChoice文書の複雑な問い合わせの例と、信頼度の定義を照合すると分かる。問い合わせを担当部署へ振り分ける同一回答で、返品部門に0.60、請求部門に0.38の確率が付き、信頼度は0.39となっている。上位候補はあるものの、別の候補にも確率が分かれている状態だ。説明用の出力例であり、実際の正答率を測定した結果ではない。
この区別を落とすと、「信頼度0.9なら90%正しい」といった読み違いが起きる。しかも、System Oneの文書は、校正は予測の集団に対して測るもので、個別の正しさを保証しないと明記している。自動処理へ進める閾値は、実際の業務データと誤りの影響を踏まえて決めなければならない。
Noulの場合は、そもそも別の信頼度がない。「返金を求めているか」への0.1は、「はい」の確率が低いという意味で、「モデルが自信を失っている」という意味ではない。0に近ければ強い否定、0.5に近ければ肯定と否定が同程度となる。すべての出力に同じ閾値を当てると、意味を取り違える。
同じ注意は、TypeSafeが掲げる「幻覚がない」という表現にも必要だ。同社が形式面で保証するのは、あらかじめ定めた型や候補を外れた値を作らないこと。たとえば実在する部署だけを候補にすれば、架空の部署名は出てこない。しかし、請求の問い合わせを技術部門へ送る誤判断は、型を守ったまま起こり得る。形式への適合、判断の正しさ、確率の校正は、別々に確かめるべき性質である。
193.6倍高速という評価をどう読むか
TypeSafeが掲げる「193.6倍高速、費用は444.6分の1」という数字は、同社の業務ワークフロー評価に由来する。対象はセキュリティ対応とAIエージェントの実行監視に加え、請求書処理と顧客対応で、集計では各業務を等しく重み付けしている。同社自身、実際の導入で得られる改善幅としては大きい側の結果だと留保を付けている。
評価は、人間が付けた正解ラベルとの比較ではない。GPT-6 AstraとClaude Fable 5.1を高い推論設定で動かし、その回答確率の平均を参照値にしている。ほかのモデルは各提供元の既定の推論設定で評価する。つまり、強力なモデル群の判断にどれほど近い結果を、どの費用と時間で出すかという試験である。参照側が間違えば、参照値への一致と現実の正しさはずれる。
LLM側にも、Jevと互換性のある構造化判断と確率を返させている点が効く。TypeSafeは、確率なしで答えを選ばせる場合より、この方法は遅く高くなりやすいと説明する。比較用に公開したアダプターには、提供元の構造化出力機能を使う設定と、確率分布か選択結果だけかを切り替える設定がある。確率分布が必要な業務には意味のある比較だが、一つのラベルだけ欲しい用途でも同じ倍率になるとは限らない。
発表が示す応答時間は70〜500ミリ秒で、公開評価は主に米西海岸のノートPCから、同じ西海岸にあるサービスへアクセスして測ったという。短い入力がJevに有利に働くデモもある。日本からの通信や長い入力、多段の処理を含めた待ち時間は、個別に測る必要がある。
料金は入力100万トークン当たり0.042ドル、10億トークンなら42ドルで、出力課金はない。これは利用者に示された販売価格であり、計算資源の消費や原価が同じ倍率で下がった証拠ではない。TypeSafeも、価格が補助されていないことや持続性を示すには時間が必要だと認めている。
第三者の試用では、速度の利点と精度の差が同時に現れている。Everyが報告したDan Shipperの試験は、正常な文章と意図的に欠陥を入れた文章を合わせた12例に、4種類の検査を適用したものだ。文章当たりの処理時間の中央値はJevが0.35秒、Fable 5.1の高い推論設定が8.83秒で、Jevは約25倍速かった。推定費用は約580分の1だった一方、意図した欠陥7件のうちJevが見つけたのは6件、Fableは7件すべてだった。
小規模な合成文章の試験を、そのまま一般的な精度へ広げることはできない。それでも、速く安い判断を大量に使う設計には利点があり、難しい判断を引き受ける推論モデルには別の役割が残ることを示す具体例ではある。
任せる判断と、コードに残す仕事
自由な文章を生成しないJevでも、文書からメールアドレスや金額を取り出す処理には使える。ただし、取り出し方が違う。TypeSafeの公式実装例では、まず正規表現で文書から候補を探し、Jevに目的の候補を選ばせ、最後にコードが元の文字列を複写して整形する。
この方法なら、選んだ金額の数字をモデルが書き直してしまう経路はなくせる。一方で、候補を拾い損ねたり、別の金額を選んだりする余地は残る。人名のように候補抽出が難しい対象では、既存の名簿や固有表現抽出器、LLMが候補を用意する必要があると文書は説明する。自由記述を手放す代わりに、候補の準備をソフトウェア側が引き受けるわけだ。
複数の問いを並列に返すことと、業務全体が一度で終わることも別である。同社の請求書処理の評価は、主題を分けた7ラウンドの質問を使う。合計や日付など、コードで計算できる項目はコードへ任せ、AIの判断を処理の分岐に使っている。前の結果を見なければ次の問いが決まらない仕事には、段階が残る。
Jevが得意とする狭い判断を先に実行し、曖昧な案件を推論モデルや人へ回す。その分担なら、既存LLMが文章を作る能力も生かせる。たとえばLLMが書いた回答を複数の観点で素早く点検し、問題がありそうな箇所だけを詳しく調べ直す、といった使い方だ。Everyの試用も、安価な検査を作業の途中へ組み込む可能性を示している。
早期アクセスが広がった後に確かめたいのは、各社の実務データで、低い信頼度の案件を外したときに誤りがどれほど減り、自動処理できる案件がどれほど残るかだ。通信を含む待ち時間と、見逃しによる手戻りも費用に入る。その条件がそろえば、Jevはこれまで費用や遅さのために省かれていた判断を、日常的なソフトウェア処理の中へ組み込めるようになる。