Huaweiは2026年9月17日、AIアクセラレーター「Ascend 960」の投入計画を大きく組み替えた。学習向けのAscend 960DTは2027年第1四半期、推論向けの960PRは同年第3四半期に用意する。前年に示した計画は、用途を分けないAscend 960を2027年第4四半期に出すというものだった。
目を引くのは最大9カ月の前倒しだが、変化は日付に収まらない。Huaweiは演算チップを用途別に分け、光接続、メモリ、ストレージまでを一体で設計する方針を鮮明にした。NVIDIAとの競争を単体チップのピーク演算性能だけで測ると、この狙いを見誤る。
9カ月前倒しより重要な「二本立て化」
2025年と2026年の公式ロードマップを並べると、製品計画の変化がはっきりする。
| 公表時点 | 製品 | 主用途 | 予定時期 | 証拠の状態 |
|---|---|---|---|---|
| 2025年9月 | Ascend 960 | 学習・推論を分けずに公表 | 2027年第4四半期 | 会社計画 |
| 2026年9月 | Ascend 960DT | 学習 | 2027年第1四半期 | 会社計画、3四半期前倒し |
| 2026年9月 | Ascend 960PR | 推論 | 2027年第3四半期 | 会社計画、1四半期前倒し |
| 2026年9月 | Ascend 970 | 未公表 | 2028年 | 年だけを公表 |
| 2026年9月 | Ascend 980 | 未公表 | 2029年 | 年だけを公表 |
2025年に2027年第4四半期とされたAscend 960は、2026年に学習向け960DTが2027年第1四半期、推論向け960PRが同年第3四半期へ分かれた。前倒しと用途別の二本立て化が同時に起きた。
Huaweiは960世代を用途別に分けたが、2製品の詳しい設計上の違いまでは説明していない。ただし、2026年の公式テキストは960DTと960PRの詳しい演算性能、メモリ容量、製造プロセスを明らかにしていない。イベント投影資料を基に詳細値を載せた報道はあるものの、公開された公式文書で再確認できない数値を確定仕様として扱うのは早い。
HuaweiはAscend 970を2028年、980を2029年に投入し、年1世代で更新するとしている。Tau Scaling Law(τスケーリング則)によって演算仕様を倍増し、メモリ帯域や容量、相互接続帯域も伸ばすという。ただし、これはHuaweiが掲げる技術目標であり、独立した測定結果ではない。
競争の単位はチップからSuperPoDへ
大規模AIでは、アクセラレーターを増やすほど通信の待ち時間が効いてくる。Huaweiによると、従来型サーバーで構成した10万NPUクラスタでは、通信が学習時間の大きな割合を占める。同社のMarkov Labは、8 NPUサーバーを並べる構成と4,000 NPUのSuperPoDを使う構成をシミュレーションし、後者のモデル演算利用率(MFU)が2.75倍になるとした。実機ベンチマークではないが、Huaweiが解こうとしている問題は分かる。
その土台がPeerium Computing Architecture(Peerium計算アーキテクチャ)とUnifiedBusである。Huaweiは、入れ子型の並列処理、物理ノードをまたぐ統一メモリアドレス、対等接続を組み合わせる。UnifiedBusはNPU同士を結ぶだけでなく、CPUとメモリ、SSDからネットワーク機器までを単一のプロトコルで接続する構想だ。
狙いは、弱いチップを数で埋め合わせるという単純な話ではない。多数のNPUを一つの論理コンピューターとして動かし、使われずに待つ演算器を減らす。ピーク性能が同じでも、通信で止まる時間が短ければ学習や推論に使える実効性能は上がるからだ。
近接実装光学が狙うのは帯域より電力と故障点
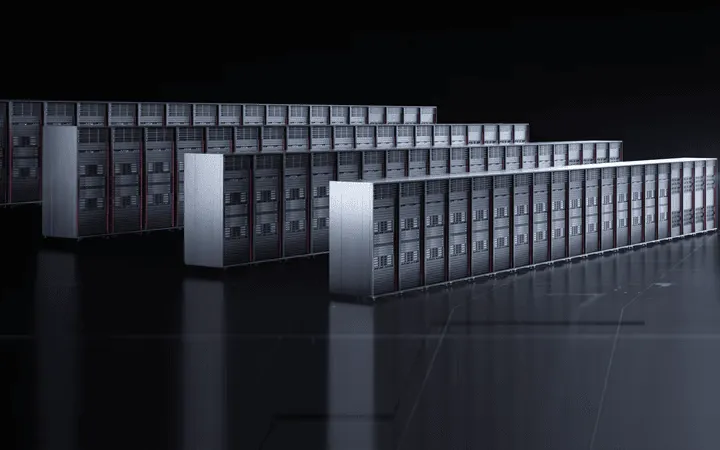
新しいAtlas 960E SuperPoDは最大4,096 NPUを収容し、Huaweiの公称値でFP8演算性能8EFLOPS、HBM容量は最大1PBに達する。だが、今回の技術的な変化は演算器の数より接続方式にある。Huaweiは近接実装光学を採用し、光学エンジンを演算装置の近くへ置いた。
同社のHi-ONEは1基あたり7.2Tbit/sを伝送する。Atlas 960Eでは5,500基を使い、従来なら必要だったという48,000個の800G光モジュールを省く。Huaweiは、この置き換えで消費電力を550kW超減らし、無故障稼働時間を2倍にしながら、システム可用性99.8%を実現すると主張する。
数字の分母には注意が要る。550kW超は光接続方式を変えたときの絶対削減量で、Atlas 960E全体の消費電力でも削減率でもない。99.8%についても、試験期間、比較対象の可用性、何を故障と数えたかは公表されていない。近接実装光学の価値を確かめるには、実運用での電力と修理時間を同じ条件で測る必要がある。
15,488 NPU版は消えたのか
Huaweiが2025年に示したAtlas 960 SuperPoDは、最大15,488個のAscend 960を収める巨大構成だった。公称値はFP8で30EFLOPS、FP4で60EFLOPS、メモリ4,460TB、相互接続帯域34PB/s。2027年第4四半期の投入を予定していた。
一方、2026年に発表したAtlas 960Eは4,096 NPUである。数だけを比べれば小さいが、Huaweiは15,488 NPU版を置き換えたのか、別構成として残すのかを公開テキストで説明していない。メモリも前者は総容量、後者はHBM最大1PBという表現であり、同じ分母かどうかが定かではない。
製品の段階も違う。Huaweiは2026年9月時点で、256,000カードのAtlas 950 SuperClusterを導入中と説明する一方、近接実装光学版Atlas 960は試験中としている。最大100万NPUという数字も、複数のSuperPoDをつなぐアーキテクチャ上の対応規模であって、稼働済みシステムの実績ではない。
残る壁はソフトウェアと供給量
ハードウェアを大規模に結べても、既存モデルを無理なく動かせなければ利用は広がらない。PyTorch Foundationは2026年9月、HuaweiとIntelが共同議長を務めるAccelerator Integration Working Groupが、ハードウェア導入指針や複数リポジトリをまたぐ継続的インテグレーション、デバイス非依存の試験を進めていると報告した。HuaweiがPyTorchの複数バックエンド対応を進める作業部会に参加していることは確認できる。だが、これはAscend自体の統合状態や、CUDAと同じソフトウェア資産・運用経験がそろったことを意味しない。
もう一つの壁は、ロードマップより物理的だ。Reutersによると、HuaweiのEric Xu輪番会長は会見で、中国国内の需要さえ満たせる供給能力がなく、海外へ全面展開する計画はないと述べた。投入時期を9カ月早めても、HBMや製造・実装能力が追いつかなければ、顧客が使える総計算量は増えない。
Ascend 960の競争力は、予定日に製品名が増えるだけでは決まらない。960DTと960PRの量産量、独立した学習・推論性能、近接実装光学の実測電力と可用性、主要モデルを移す工数がそろって初めて、SuperPoD戦略が公称値から実用へ移ったと判断できる。