NVIDIAは2026年9月14日、誤り耐性量子計算の設計基盤「CUDA-Q Logical」をオープンソースのCUDA-Qへ追加した。論理プログラムを誤り訂正符号へ割り当て、物理量子ビットの配置と実行順序を決め、古典側の復号処理までつなぐためのコンパイラ基盤である。実用規模の誤り耐性量子コンピューターが完成したわけではなく、同時期に公開された中核論文も査読前のプレプリントにとどまる。それでも、この発表は量子計算の進歩を量子ビット数だけで語る段階から、どの仮定で、どの回路を、どの速度で成功させられるかを検証する段階へ移す。
P0からP4へ、仮定を捨てずに具体化する
誤り耐性量子計算では、一つの論理量子ビットを多数の壊れやすい物理量子ビットへ符号化する。だが、必要数は符号だけで決まらない。論理演算の分解、補助状態の供給、量子ビットの移動、測定、古典側の復号、補正を返す期限のいずれかが変われば、必要な量子ビット数と実行時間がともに動く。専門ツールを手作業でつなぐ設計では、途中で置いた仮定や数字の由来が失われやすかった。
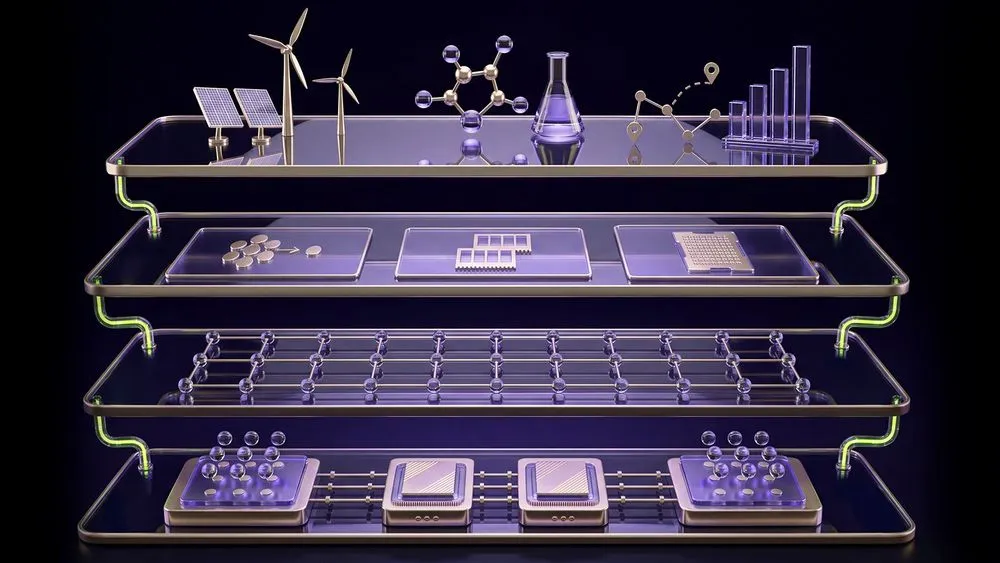
CUDA-Q Logicalは、この断線を五つの段階に分けて扱う。P0は装置や符号に依存しない論理プログラム、P1は符号をまだ選ばない論理配置と資源供給を表す。P2では量子誤り訂正(QEC)の符号と演算手順を選び、検出器と失敗時の再試行を束縛する。P3では物理資源と装置固有の演算を定め、雑音と時間を与えて実行順序を作る。P4では命令を配信し、誤りの兆候を示す測定結果の転送、復号期限、量子側へのフィードバックを決める。
肝は、早い段階で全条件を一つの数字へ押し込まないことだ。同じP0のプログラムを保ったまま、符号、復号器、実行方式、ハードウェア記述を型付きの境界で差し替えられる。二つの見積もりが違ったとき、アルゴリズムを書き換えたためか、誤り訂正方式を変えたためか、装置の制約を変えたためかを追いやすくなる。
ただし、論文が示すのはコンパイラの変換、モデル照合、シミュレーションである。P0からP4へ正しく変換でき、実行可能なスケジュールを作れたとしても、それが最適な設計であるとは限らず、将来の実機性能を正確に予測する保証もない。arXiv:2609.13388は2026年9月11日提出の作業草稿で、著者は全員NVIDIAに所属する。第三者による査読と、異なる装置での再現はこれからだ。
一つの見積もりを四つに分解する
CUDA-Q Logicalの公式文書は、資源見積もりをLOGICAL、STATIC、ANALYTICAL、SCHEDULEの四段階に分ける。いずれも同じプログラムを対象にできるが、答える問いは異なる。
| 見積もり | 必要な段階と仮定 | 主な出力 |
|---|---|---|
| LOGICAL | P0。装置も符号も未選択 | 論理演算数、論理量子ビット数、合成が必要な演算 |
| STATIC | P2。符号、符号化、演算手順を選択 | 符号化後の演算、資源、誤り検出用の測定回数 |
| ANALYTICAL | P2に物理誤り率や時間モデルを追加 | 論理誤り、受理率、時間、物理量子ビット数、再試行 |
| SCHEDULE | P3。物理イベントと依存関係を具体化 | 所要時間、資源が占有される時間、利用率 |
CUDA-Q Logicalの4段階の資源見積もりは、同じプログラムについて、誤り訂正方式を選ぶ前の論理演算、選択した符号・手順の静的計数、物理仮定を置いた解析値、物理スケジュール由来の所要時間と利用率を分けて返す。数字の詳細度が上がるほど仮定も増える。
したがって、SCHEDULEの値がLOGICALより「正しい」という関係ではない。前者は装置を具体化した問いへ詳しく答える一方、誤り率、演算時間、接続性、移動方式といった入力に強く縛られる。別々の設計を比較するなら、ワークロードと成功条件をそろえ、どの段階まで同じ仮定を共有したかを明示する必要がある。
公式の能力表にも境界がある。P0からP3、各種見積もり、RSA-2048の用例、量子回路シミュレーターStimへの出力などは実行例がある。一方、動的な符号、符号の切り替え、連接符号、検出結果をさらに検査する仕組みなどは、パッケージ内に型や機能があっても実行テストや用例がないプレビュー面として残る。APIの存在は、完全な実行経路の実証ではない。
15万量子ビットと「7倍」を実機性能と混同しない
DiraqとIceberg Quantumは、Pinnacleと呼ぶ量子化学アルゴリズムをシリコンスピン量子ビットへ割り当て、1,000論理量子ビットに約15万物理量子ビットを使う目標モデルを示した。ハードウェアの制約を取り込んだCUDA-Q Logicalの見積もりは、Pinnacle論文の物理量子ビット数と5%以内で一致したという。さらに、量子ビットを移動させるシャトリングの雑音を含む数値シミュレーションも行った。
ここで検証されたのは、設計モデルを別の計算経路で再現し、装置固有の仮定を追加できることだ。15万個の物理量子ビットを持つ装置を建設し、1,000個の論理量子ビットを運転した結果ではない。製造歩留まり、制御配線、校正、長時間の安定性は、モデルの一致だけでは確かめられない。
NVIDIAはFermilabの事例として、従来は専用基盤の構築に約5か月を要したが、CUDA-Q Logicalで誤り訂正方式の組み合わせを探索し、3週間へ短縮したと説明する。期間だけを割れば約7倍だが、短くなったのは量子回路の実行時間ではなく設計ワークフローである。公開資料には対象作業、チーム規模、比較条件、再現手順の詳述がなく、生産性の一般則にはできない。
二つの数字が示す価値は、実機の性能向上よりも、設計案を同じ器で比較し直せる点にある。反対に、ソフトウェアだけで同一装置の量子ビット数を10分の1にした、あるいは計算速度を7倍にしたと読むのは行き過ぎである。
QUOPSは量子ビット数ではなく回路の形と速度を測る
Sandia National Laboratories、Quantinuum、NVIDIAなどの研究者は、量子計算機の実効能力を測る指標「QUOPS」をarXiv:2609.12146で提案した。回路は任意角のパウリ回転とCNOTの層を交互に置き、幅wと演算規模sを別々に変える。平均プロセス偏極が1/√e、約61%以上であることを95%の信頼水準で確認できた形状を成功とし、w²以上w³以下の領域で成功した最大規模をスコアにする。
もう一つの軸が毎秒処理量である。成功率を確かめるために増やしたサンプル数と、事後選別で捨てた実行も速度へ反映する。大きい回路を一度通せても、結果を得るまで膨大な試行が必要なら、実用上の能力を高く見積もらない設計だ。
| 構成 | QUOPSスコア | 毎秒処理量 | 回路幅 |
|---|---|---|---|
| Google Willow | 216 | 2.0×10^7 | 6 |
| IBM ibm_boston | 204 | 3.1×10^5 | 6 |
| Quantinuum H2-1 | 1,320 | 353 | 12 |
| Quantinuum Helios-1 | 1,504 | 303 | 16 |
| Helios-1、Steane [[7,1,3]]論理実装 | 40 | 4.9 | 4 |
QUOPSの実測では、物理量子ビット機はスコアと処理量の順位が一致せず、Helios-1上の小規模論理実装は40 QUOPS・4.9 QUOPS毎秒だった。ベンチマークは大きな回路を通せるかと、その速度を別軸で読む設計である。
この表は汎用的な機種ランキングではない。接続性、コンパイル、物理方式が違い、論理実装も最大8個の符号化論理量子ビットを用いた小規模な試験である。Steane符号は性能が最適だからではなく、実装が単純なため選ばれた。論文自体も2026年9月10日提出の査読前プレプリントである。
QUOPS論文は、RSA-2048の素因数分解と窒素固定酵素の活性中心FeMocoの計算に必要な資源を換算し、現在の装置から約5桁の能力増が必要だと見積もる。ただし、これらの用途を実機で直接走らせた結果ではない。Toffoli演算中心の回路を、パウリ回転中心のQUOPS回路へ読み替える仮定が入る。また、誤り緩和によって偏極1%の例でスコアを約3〜11倍にできても、毎秒処理量は3〜4桁落ちる。スコアだけを切り出せば、サンプリングの代償が消える。
古典GPUは誤り訂正の制御ループに入る
誤り訂正は量子チップの内部だけでは完結しない。装置が測った誤りの兆候を古典計算機へ送り、復号器が意味を読み取り、次の量子動作に間に合うよう補正情報を返す必要がある。符号が大きくなるほど測定データは増え、許される遅延は装置と手順に縛られる。
CUDA-Q LogicalのP4は、命令配信、測定結果の転送、復号の期限、フィードバックを制御計画として表す。その実行経路の一つがcudaq-realtimeであり、量子制御系からCPUやGPU上の処理へ遠隔手続きを呼び出し、共有リングバッファーなどを介して結果を返す。NVQLinkは量子プロセッサとGPU計算基盤を結ぶ接続仕様として、この往復を支える。
両者を混同してはいけない。CUDA-Q Logicalは制御計画を作るコンパイラ層で、cudaq-realtimeは計画を動かすための実行経路である。公開された遅延値も個別構成の通信と制御を測ったもので、任意の符号や復号器が期限内に動く保証ではない。
それでも、NVIDIAの位置取りは見えてくる。同社は量子プロセッサそのものを製造しなくても、シミュレーション、コンパイル、古典側の復号、ネットワークを共通基盤へまとめられる。これはCUDA-Q Logical、cudaq-realtime、NVQLinkの役割配置から導く解釈であり、NVIDIAの事業戦略全体を断定するものではない。
モデルと実機を閉じる検証
CUDA-Q Logicalが共通基盤として定着するかは、提携企業の数では決まらない。同じP0プログラムを異なる符号と装置へ落とし、どの仮定が資源差を生んだかを第三者が再現できることが第一の条件になる。次に、SCHEDULEが予測した所要時間と利用率が実機測定にどこまで一致し、QUOPSのスコアと毎秒処理量が設計変更へどう戻されるかを確かめなければならない。
さらに、現在は用例のない動的符号、符号切り替え、連接符号が実行テストへ移り、P4の制御計画が複数ベンダーの制御系と復号器をまたいで期限を守れるかを実機で確かめる必要がある。査読、再現実験、実機との閉ループがそろえば、CUDA-Q Logicalは未来の量子機を予言する計算機ではなく、予測が外れた理由まで追える設計の共通言語になり得る。