

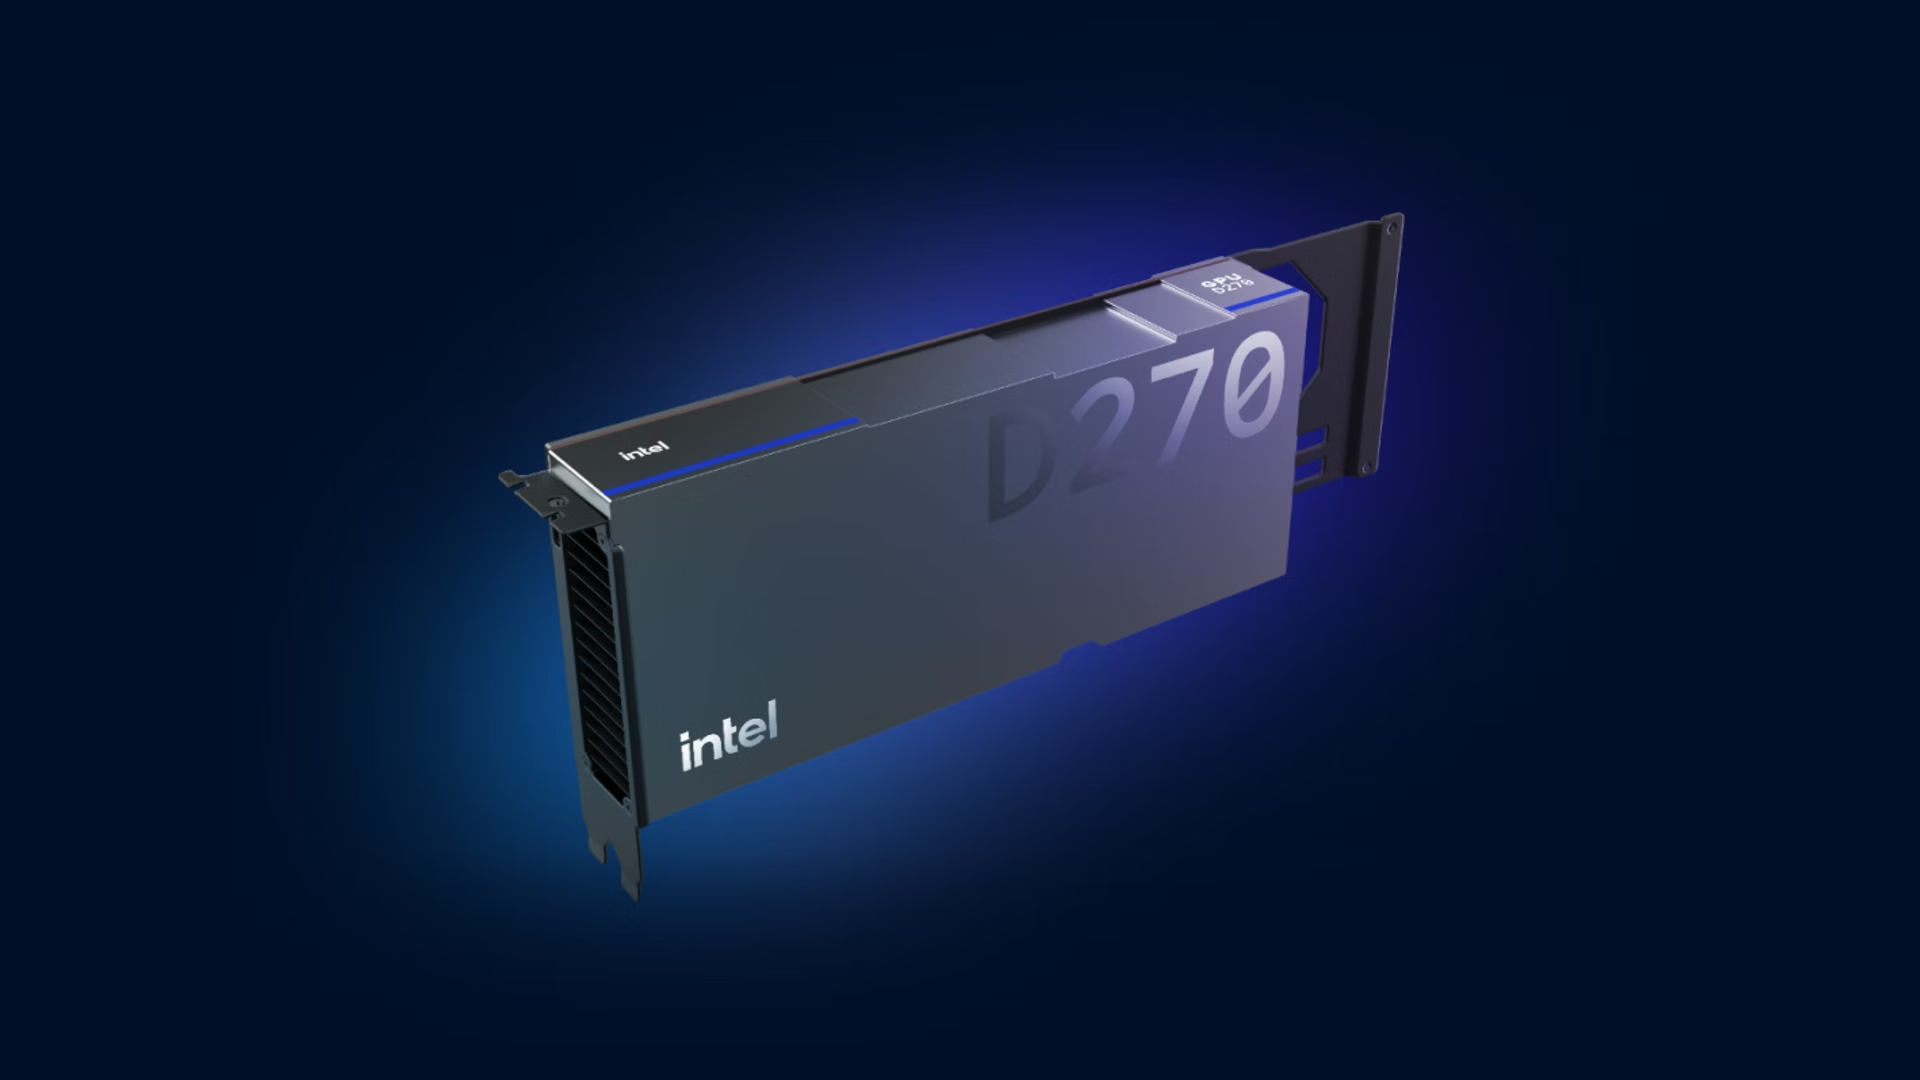
- 何が起きた: IntelがAI推論向けGPU「Intel GPU D-series」の詳細を発表し、FP8演算性能1.3PFLOPS、メモリ帯域1.5TB/sなどの仕様を明らかにした。顧客向けのサンプル提供も開始している。
- なぜ重要か: 最大480GBの大容量メモリと350Wの空冷PCIeカードという設計により、既存のサーバー環境で大規模AIモデルや多数の推論リクエストを効率よく処理することを目指している。
- 次に見るべき点: 正式な発売時期と価格に加え、同じAIモデルと精度、同時リクエスト数を条件にそろえた推論速度、処理能力、消費電力の比較が重要になる。
Intelは2026年10月12日(米国時間)、AI推論向けGPU「Intel GPU D-series」の詳細を発表し、FP8演算性能1.3PFLOPS、メモリ帯域1.5TB/sなどの主要仕様を明らかにした。開発コード名「Crescent Island」として知られていたGPUで、最大480GBのLPDDR5Xメモリを搭載できる設計ながら、消費電力枠を350Wに抑えた空冷PCIeカードとして提供される。顧客向けのサンプル出荷も始まっている。
今回の発表で、これまで強調されてきた大容量メモリに加え、演算性能やメモリ帯域の具体的な数値が示され、Intelが狙うAI推論市場での位置付けがより明確になった。
ただし、大規模なAIモデルをGPUのメモリに収められることと、そのモデルを高速に実行できることは別の問題だ。D-seriesの実力を判断するには、メモリ容量だけでなく、推論時の応答速度や同時処理能力、消費電力を総合的に評価する必要がある。
「Intel GPU D270」の名称も公開、顧客向けサンプル提供を開始
Intelは今回のOCP Global Summitで、これまでCrescent Islandというコードネームで開発してきたAI推論向けGPUの正式な製品系列を「Intel GPU D-series」と発表した。
同時に公開された製品ページには、「Intel GPU D270」という名称も登場している。
D-seriesは、IntelのXe3Pアーキテクチャを採用し、大規模言語モデル(LLM)の推論処理に必要なメモリ容量と演算性能、電力効率を重視して設計されている。
Intelの公式発表によると、主な仕様はFP8演算性能1.3PFLOPS、メモリ帯域1.5TB/s、消費電力枠350Wとなっている。
FP8は8ビットの浮動小数点形式で、AIモデルの演算に使われるデータ形式の一つだ。1.3PFLOPSは、毎秒1,300兆回に相当する浮動小数点演算性能を表す。
ただし、これはGPUの演算能力を示す数値であり、AIが実際に毎秒どれだけの文章を生成できるかを示すものではない。Intelは今回、具体的なAIモデルを使ったトークン生成速度の比較結果を公表していない。
メモリ容量についても、製品構成による違いに注意が必要だ。
Intelの発表によると、Intelブランドで提供されるPCIeカードのメモリ容量は160GBで、最大480GBはパートナー企業が設計するODMブランドのカードで実現可能な上限となっている。
つまり、D270を搭載したすべてのカードに480GBのメモリが搭載されるわけではない。実際に選択できる容量は、製品を提供するメーカーやカードの構成によって異なる。
Xe3Pアーキテクチャと大容量メモリを採用する方針自体は、今回初めて明らかになったものではない。
Intelは2025年10月14日の発表で、Crescent Islandに160GBのLPDDR5Xメモリを搭載し、2026年後半から顧客向けサンプルを提供する計画を示していた。
今回の発表では、予定していたサンプル提供が実際に始まったことが確認された。一方、一般販売の開始時期や価格については、まだ明らかになっていない。
AMD・NVIDIAの競合GPUと比較して見える、大容量メモリの強み
Intel GPU D-seriesの特徴を理解するには、同じPCIeカード型のデータセンター向けGPUと比較すると分かりやすい。
大規模なAIシステムでは、液冷を前提とした高密度ラック型の構成も利用される。しかし、D-seriesが重視しているのは、既存のサーバー環境に導入しやすい空冷PCIeカードという形態だ。
そこで、AMDの「Instinct MI350P」と、NVIDIAの「RTX PRO 6000 Blackwell Server Edition」を比較対象とする。
| 公表仕様 | Intel GPU D-series | AMD Instinct MI350P | NVIDIA RTX PRO 6000 Blackwell Server Edition |
|---|---|---|---|
| メモリ容量 | Intelブランド品160GB、ODM設計では最大480GB | 144GB | 96GB |
| メモリの種類 | LPDDR5X | HBM3E | GDDR7 |
| メモリ帯域 | 1.5TB/s | 4TB/s | 1.597TB/s |
| カードの公称電力 | 350W | 最大600W、450Wに設定可能 | 最大600W、設定変更可能 |
| 製品形態 | 空冷PCIeカード | パッシブ冷却PCIeカード | 空冷PCIeカード |
※2026年10月13日時点の各社公表仕様に基づく。AMDはMI350Pの製品仕様、NVIDIAはRTX PRO 6000 Blackwell Server Editionの製品仕様を参照。NVIDIAのメモリ帯域1597GB/sは、十進単位で1.597TB/sと表記した。Intel GPU D-seriesは顧客向けサンプルの段階であり、最大480GBはパートナー設計のカードで実現可能な上限だ。
AMD Instinct MI350Pと比較すると、D-seriesのIntelブランド製品は約1.11倍、パートナー設計の最大構成では約3.33倍のメモリ容量を搭載できる計算になる。
一方、メモリ帯域はMI350Pの4TB/sに対して1.5TB/sであり、37.5%にとどまる。
つまり、D-seriesはMI350Pより多くのデータをGPU内に保持できる構成を選べる一方、単位時間にメモリから読み書きできるデータ量では劣る。
ただし、NVIDIA RTX PRO 6000 Blackwell Server Editionと比較すると、状況は異なる。
RTX PRO 6000のメモリ容量は96GB、メモリ帯域は1.597TB/sだ。D-seriesはIntelブランドの160GB構成でもメモリ容量が大きく、帯域は近い水準となっている。
この違いから、D-seriesが特に大容量メモリを必要とする推論処理を重視していることが分かる。
もっとも、これらは単一カードの公表仕様を比較したものであり、実際のAI推論速度を示すものではない。
メモリ帯域が大きいGPUでも、演算性能やソフトウェアの最適化が不十分であれば、期待した性能を発揮できない場合がある。逆に、メモリ容量の大きさによってモデルを複数のGPUへ分割せずに済めば、構成によっては処理効率が改善する可能性もある。
消費電力についても同様だ。
D-seriesの350Wという電力枠は、競合製品の最大設定である600Wより低い。しかし、同じ処理を完了するまでに必要な時間が異なれば、消費する電力量も変わる。
350Wという仕様だけから、AIの1トークンを生成するための電力量や、実際の運用コストで競合製品より優れていると結論付けることはできない。
また、Intelが公表したFP8演算性能1.3PFLOPSについては、構造化スパース性を利用する条件なのかが明確ではない。
他社のFP8性能には、スパース性の有無によって異なる数値が用意されている場合があるため、条件をそろえずに数値だけを比較して演算性能の優劣を判断するのは適切ではない。
最大3,000億パラメータ対応、その条件はメモリ容量と量子化次第
IntelはD-seriesについて、単体カードで最大3,000億パラメータ、8GPU構成では1兆パラメータを超えるAIモデルに対応できると説明している。
しかし、この数字を評価するには、AIモデルをどのような精度で保持し、推論中に必要となるデータのためにどれだけメモリを確保するかを考える必要がある。
今回の発表では、3,000億パラメータのモデルを動かす際の具体的なカード容量や量子化条件は示されていない。
大規模言語モデルをGPU上で動かす場合、まずモデルのパラメータを保存するためのメモリが必要になる。
例えば、3,000億パラメータをすべて8ビットで保存する場合、重みデータだけで必要な容量は単純計算で約300GBとなる。
一方、4ビットで保存できれば、理論上は約150GBまで削減できる。
この計算は、パラメータ数に1パラメータ当たりの保存容量を掛けたものだ。NVIDIAの推論最適化に関する技術解説でも、モデルの重みとKVキャッシュがGPUメモリを消費する主要な要素として説明されている。
ただし、実際の推論では重みデータ以外にもメモリが必要になる。
量子化した数値を元のスケールに戻すための情報や、一時的な計算領域、推論中に使用するデータなども保持しなければならない。
特に重要なのが「KVキャッシュ」だ。
大規模言語モデルは、文章を生成する際に、それまでに処理したトークンに関する情報を参照する。KVキャッシュは、その情報の一部を保存し、同じ計算を何度も繰り返さずに済むようにする仕組みだ。
入力する文章が長くなるほど、また同時に処理するリクエストが増えるほど、KVキャッシュに必要な容量も大きくなりやすい。
仮に160GBのカードへ、4ビットで量子化した3,000億パラメータのモデルを配置すると、重みだけで約150GBを使用する計算になる。
単純な差し引きでは約10GBが残るが、実際には量子化に付随する情報や計算用のメモリも必要になるため、利用可能な余裕はさらに小さくなる。
そのため、Intelブランドの160GBカードで3,000億パラメータのモデルを扱えるとしても、長い入力や多数の同時リクエストを伴う推論まで十分な性能で実行できるとは限らない。
一方、最大480GBのメモリを搭載するパートナー設計のカードであれば、同じモデルを保持した後にも、より多くのメモリを推論処理に利用できる可能性がある。
ただし、実際にどれほどの余裕が生まれるかは、モデルの構造や量子化方式、入力長、同時実行数によって変わる。
Intelが掲げる最大3,000億パラメータへの対応は、特定の条件下で大規模モデルを扱えることを示すものであり、あらゆるモデルや推論設定で快適な動作を保証する数字ではない。
大容量メモリは、AIの応答速度と同時処理能力にどう影響するのか
D-seriesが狙う用途を理解するには、大規模言語モデルの推論処理を二つの段階に分けて考える必要がある。
一つは、利用者が入力した文章をまとめて処理する「プリフィル(Prefill)」だ。
もう一つは、処理した入力に基づき、回答のトークンを一つずつ生成する「デコード(Decode)」である。
プリフィルでは、入力された多数のトークンを並列に処理できるため、GPUの行列演算能力を活用しやすい。
IntelはD270の製品ページで、32基のXe3Pコアと256基のXMX行列演算エンジンを搭載し、こうした入力処理を高速化すると説明している。
また、従来のGPUでグラフィックス処理やレイトレーシングに使われていた回路の面積を、演算処理に振り向けたことも明らかにしている。
これは、画像描画よりもAI推論に必要な計算能力を重視した設計といえる。
一方、デコードでは、直前までに生成した文章を参照しながら、次のトークンを順番に生成していく。
特に同時リクエスト数が少ない場合、計算能力よりもモデルの重みやKVキャッシュをメモリから読み出す速度が、処理性能を制限することがある。
このような状況では、メモリ帯域が重要になる。
D-seriesは最大480GBという大容量メモリを搭載できる一方、帯域は1.5TB/sとなっている。そのため、モデル全体を1枚のカードに収められたとしても、必ずしも1トークン当たりの生成時間が短くなるわけではない。
ただし、大容量メモリには別の利点もある。
同じAIモデルに対して複数の利用者からリクエストが届く場合、それらをまとめて処理する「バッチ処理」によってGPUの利用効率を高められる。
このとき、モデルの重みは複数のリクエストで共有できるが、KVキャッシュは各リクエストに応じて保持する必要がある。
モデルを読み込んだ後にも十分なメモリが残っていれば、より多くのリクエストを同時に処理しやすくなる。
つまり、D-seriesの大容量メモリは、1人の利用者への応答速度だけでなく、多数の利用者にAIサービスを提供する際の処理能力を高める方向で効果を発揮する可能性がある。
もっとも、同時リクエスト数を増やせば、その分だけKVキャッシュの使用量も増える。バッチ処理によってメモリ帯域や演算器への負荷が変化し、リクエストをまとめるための待ち時間が発生する場合もある。
そのため、最適な構成は用途によって異なる。
例えば、企業内の多数の従業員が共通のAIアシスタントを利用する場合には、サーバー全体で処理できるリクエスト数やトークン数が重要になる。
一方、少人数が対話型AIを利用する場合には、最初の回答が返ってくるまでの時間や、文章が生成される速度が重視される。
また、プリフィルが常に演算性能だけで決まり、デコードが常にメモリ帯域だけで決まるわけでもない。モデルの規模や構造、入力長、同時実行数によって性能上の制約は変わる。
D-seriesの実際の性能を評価するには、こうした運用条件をそろえた測定が不可欠だ。
350Wの空冷設計が狙う、既存サーバーでのAI推論
Intel GPU D270は、標準的なPCIe 5.0接続と350Wの空冷設計を採用している。
Intelが重視しているのは、専用の液冷設備や大規模なラックの改修を必要とせず、既存のデータセンター環境にAI推論用GPUを導入しやすくすることだ。
大容量メモリを搭載したGPUを、比較的低い電力枠で運用できれば、サーバーの電源容量や冷却能力に制約がある環境でも、AI推論の処理能力を増やせる可能性がある。
ただし、標準的なPCIeカードだからといって、あらゆるサーバーにそのまま搭載できるわけではない。
実際の導入には、電源容量、カードの寸法、サーバー内部のエアフロー、PCIeスロットの構成などを確認する必要がある。
また、GPU単体の消費電力が低くても、同じ仕事を終えるまでに長い時間がかかれば、サーバー全体の電力効率が優れるとは限らない。
D-seriesの350Wという仕様が実用上どれほど有利なのかは、実際の推論処理に必要な時間と消費電力量を測定して初めて判断できる。
ソフトウェアへの対応も重要だ。
Intelは、共通のXeソフトウェア基盤を通じて、PyTorchやvLLMなど既存のAI開発環境を活用できるようにする方針を示している。
これは、開発者が既存のソフトウェア資産を利用しながら、IntelのGPUへAI推論環境を移行しやすくする狙いがある。
もっとも、実際に利用したいモデルや量子化形式が正しく動作し、十分な性能を発揮できるかは、今後の検証が必要だ。
特に、AI推論の性能はハードウェアだけで決まるものではない。モデルに合わせた演算処理の最適化、メモリ管理、バッチ処理の仕組みなど、ソフトウェア側の成熟度も大きく影響する。
Intelが掲げる8GPU構成で1兆パラメータ超のモデルに対応するという目標についても、同様の注意が必要になる。
複数のGPUを搭載しても、それぞれのメモリが自動的に一つの巨大なメモリ空間として使えるようになるわけではない。
大規模モデルを複数のGPUに分割する場合には、計算処理の分担方法やGPU間の通信性能が重要になる。
そのため、単体GPUのメモリ帯域1.5TB/sを8倍するだけで、8GPU構成の推論性能を求めることはできない。
また、LPDDR5Xを採用したことが、製品価格の安さや供給の安定性に直結するとも限らない。実際の価格や調達条件は、今後発表される製品構成や販売体制によって変わる。
今回の顧客向けサンプル提供によって、こうした実用上の性能や導入条件を具体的に評価する段階に入ったといえる。
今後、特に重要になるのは、同じAIモデルと量子化精度、入力長を使用し、同時リクエスト数を変えながら性能を比較することだ。
その際には、最初のトークンが生成されるまでの時間、後続トークンの生成間隔、サーバー全体で処理できるトークン数、消費電力などを確認する必要がある。
大容量メモリによってGPUの枚数を減らしながら、求められる応答速度と処理能力を維持できるかどうかが、D-seriesの競争力を左右する。
Intel GPU D-seriesは、単純に最高の演算性能を追求するのではなく、大容量メモリと比較的低い電力枠を組み合わせ、既存のサーバーで大規模AI推論を運用しやすくする方向を目指している。
この設計が企業にとって魅力的な選択肢となるかどうかは、今後明らかになる価格や販売時期に加え、実際のAIモデルを使った推論性能と運用コストの検証結果にかかっている。