キオクシアは2026年10月8日、GPU向けSSD「KIOXIA GPシリーズ」の改良版について、512バイトのランダム読み出しで2,000万IOPSを超える性能を示す技術デモを予告した。第3世代の高速フラッシュメモリ「XL-FLASH」を採用し、8月に発表した「GP1」の最大1,000万IOPSから、読み出し性能を2倍以上に引き上げる。
狙いは、大容量ファイルを一度に転送する速度ではなく、GPUが必要とする小さなデータを大量に読み出す処理能力の向上だ。AI向けの高速メモリであるHBM(広帯域メモリ)をフラッシュストレージで補完する構想では、メモリチップ自体の性能だけでなく、GPUがデータを読み出す仕組みも重要になる。今回の発表は、その実現に向けた技術開発がどこまで進んだのかを示している。
2,000万IOPS超を実現する512バイト読み出しの技術デモ
キオクシアは、米カリフォルニア州サンノゼで10月12〜15日に開催される「OCP Global Summit」で、GPシリーズ改良版の技術デモを披露する予定だ。
同社の発表によると、改良版には第3世代XL-FLASHを搭載し、512バイト単位のランダム読み出しで2,000万IOPSを超える性能を示すという。
IOPS(Input/Output Operations Per Second)は、ストレージが1秒間に処理できる入出力操作の回数を表す指標だ。特に、小さなデータを頻繁に読み書きする用途では、ストレージ性能を評価する重要な指標になる。
比較対象となるのが、8月4日に開発が発表された「GP1」だ。
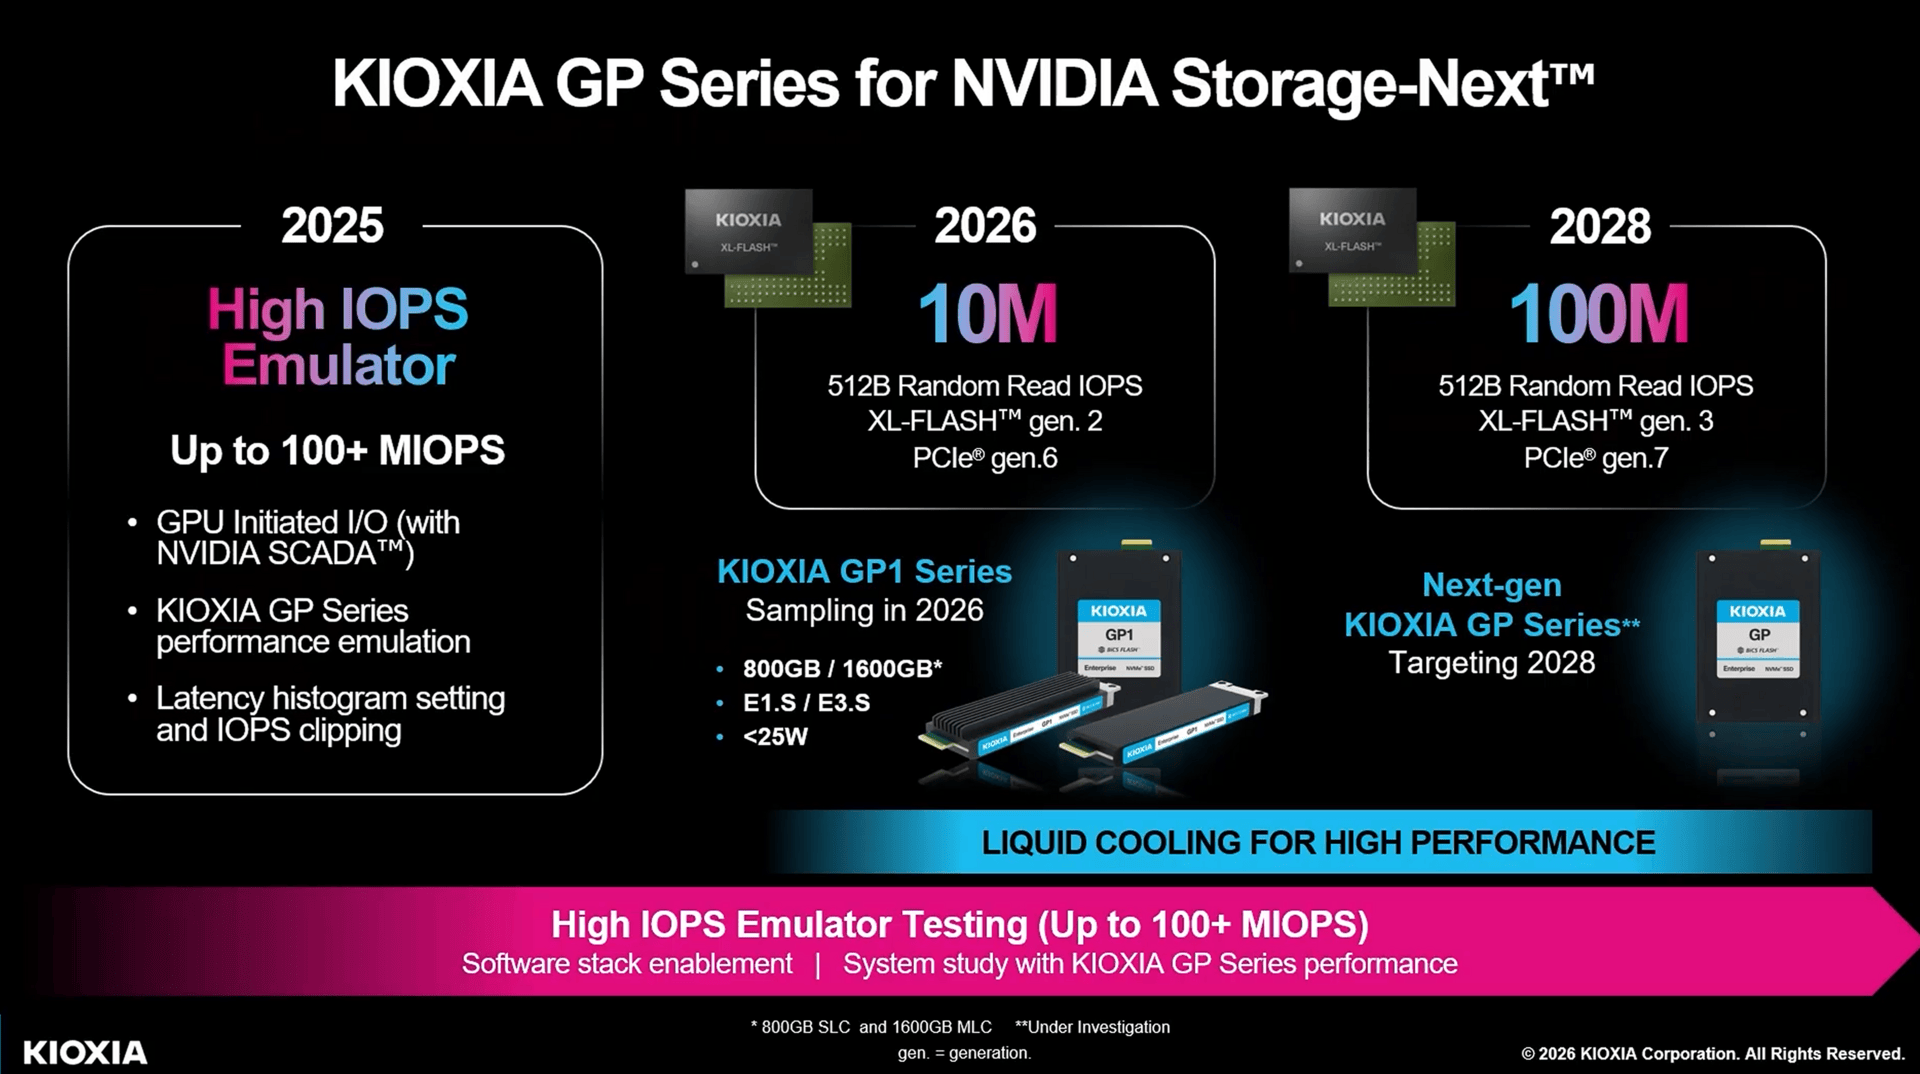
GP1は、第2世代XL-FLASHとPCIe 6.0を組み合わせ、512バイト単位のランダム読み出しで最大1,000万IOPSを実現するとしていた。
今回の改良版では、同じ512バイト単位の読み出し性能が2倍以上に向上することになる。
| 比較項目 | GP1(8月発表) | GPシリーズ改良版(10月発表) |
|---|---|---|
| 搭載フラッシュメモリ | 第2世代XL-FLASH | 第3世代XL-FLASH |
| 512バイトのランダム読み出し | 最大1,000万IOPS | 2,000万IOPS超の技術デモを予告 |
| 公表された開発・提供状況 | 2026年末までに限定顧客向けの評価用サンプルを出荷予定 | OCP Global Summitで技術デモを実施予定 |
ただし、これらは同じ機材や条件で測定した独立ベンチマークの結果ではない。
また、今回の発表は技術デモの予告であり、改良版SSDの量産開始や正式な製品発売を発表したものでもない。
では、2,000万IOPSとは、実際にどの程度のデータを読み出せる性能なのだろうか。
仮に1回の読み出しで512バイトを転送し、1秒間に2,000万回処理した場合、読み出すデータ量は次のようになる。
1GBを10億バイトとする十進表記では、10.24GB/sに相当する。
今回予告された性能は2,000万IOPSを超えるため、同じ条件で換算すれば、読み出すデータ量も10.24GB/sを超える計算だ。
ただし、これは512バイトの読み出し要求を基に算出したデータ量であり、SSDのシーケンシャル読み出し速度を実測した値ではない。通信や制御に伴う付随的なデータも含んでいない。
今回の数値が示しているのは、小さなデータを大量に読み出す処理能力の高さだ。
また、IOPSが高いからといって、1回の読み出しが完了するまでの時間も必ず短いとは限らない。
SSDは複数の読み出し要求を並行して処理できるため、1秒間の処理回数だけで、個々の要求に対する応答時間を求めることはできない。
GPU向けストレージとしての実用性を評価するには、IOPSだけでなく、読み出しの遅延時間も確認する必要がある。
第3世代XL-FLASHは読み出し性能が3倍、SSD全体では2倍超
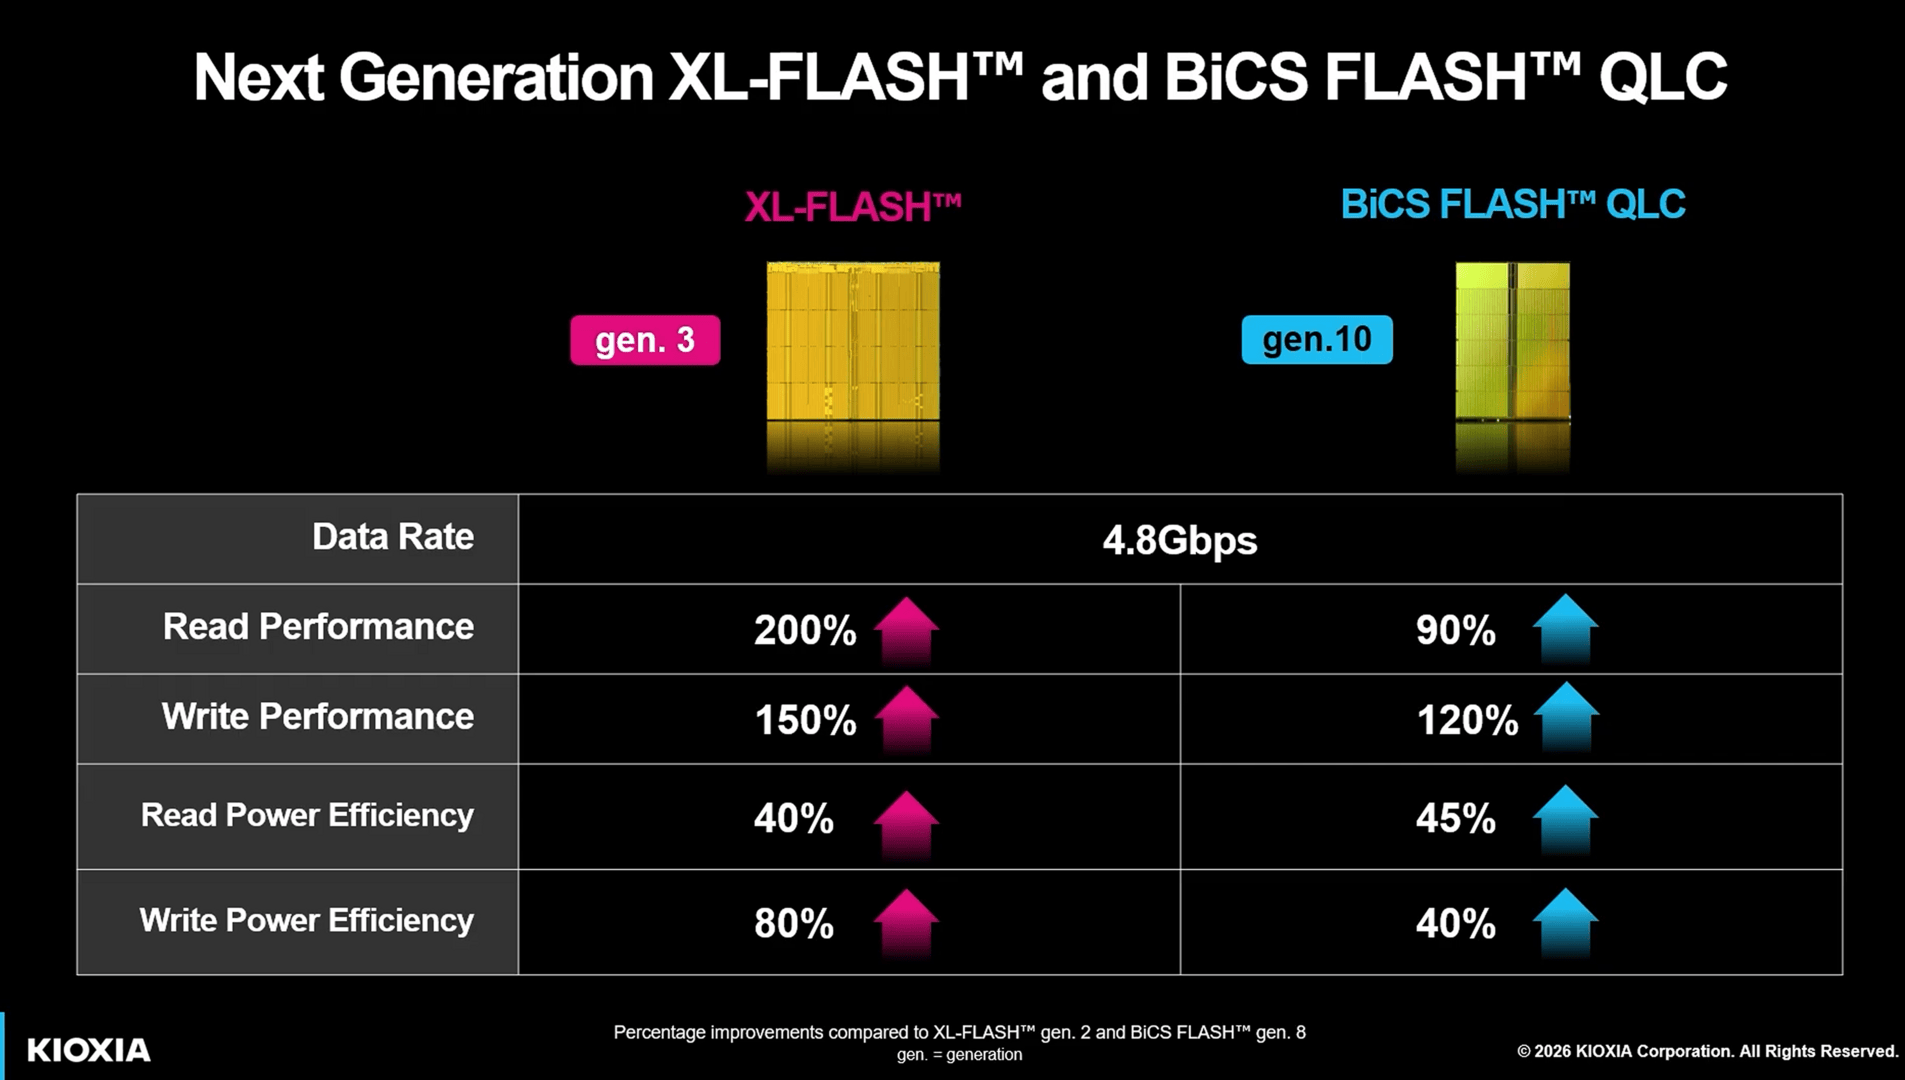
キオクシアが公開した第3世代XL-FLASHの比較資料では、第2世代と比較して、読み出し性能が200%、書き込み性能が150%向上するとされている。
これは、第2世代の性能を基準にすると、読み出しが3倍、書き込みが2.5倍になるという意味だ。
ただし、この数値と、今回のGPシリーズ改良版が示す2,000万IOPS超という性能は、測定対象が異なる。
前者はXL-FLASH自体の性能向上を示すものであり、後者はSSD全体としてのランダム読み出し性能を示すものだ。
また、比較資料には詳しい測定条件や評価方法が記されていない。そのため、第3世代XL-FLASHの性能向上が、SSD全体でどの程度の改善につながったのかを、この数値だけから判断することはできない。
そもそもXL-FLASHは、大容量化を優先する一般的なNANDフラッシュとは異なり、低遅延でのデータアクセスを重視して設計されている。
キオクシアの製品説明によると、メモリセルに接続するワード線やビット線を短くし、周辺回路も最適化することで、高速な読み出しを実現している。
また、メモリ内部の処理を分担する「プレーン」の構成も特徴の一つだ。
既存のXL-FLASH製品では、16個の物理プレーンを採用している。プレーンは独立した動作が可能な領域を区分するもので、NANDフラッシュの積層数とは異なる。
ただし、今回発表された第3世代XL-FLASHについては、プレーン数や詳細な内部構造が明らかにされていない。
既存製品の構造はXL-FLASHが高速に動作する仕組みを理解するうえで参考になるが、第3世代でも同じ内部構成が採用されているとは限らない。
また、512バイト単位の読み出しについても注意が必要だ。
GPシリーズが対応する512バイトという数値は、ホスト側からSSDへ要求するデータの大きさを表している。
一方、既存のXL-FLASHの製品説明では、NAND内部の物理的なページサイズは4KBとされている。
つまり、ホスト側から512バイト単位でデータを要求できても、NAND内部で必ず512バイトだけを読み出しているとは限らない。
今回の仕様だけで、内部で余分なデータを読み出す処理がすべて解消されたと判断することはできない。
電力効率についても、第3世代XL-FLASHの比較資料では、第2世代に対して読み出しで40%、書き込みで80%改善するとされている。
ただし、電力効率の向上と消費電力の削減は同じ意味ではない。
例えば、同じ電力でより多くの処理を実行できるようになれば、消費電力が変わらなくても電力効率は改善する。
そのため、今回の資料に示された性能向上率と電力効率の改善率だけでは、SSD全体が何ワットで動作するのか、1回の読み出しにどれだけのエネルギーを消費するのかは分からない。
データセンターへの導入を検討する場合には、SSD全体の消費電力や発熱量を実測したデータが必要になる。
GPUから直接データを読み出す「Storage-Next」とSCADA
GPシリーズが目指しているのは、単に高速なSSDを開発することではない。
GPUが必要とするデータを、より効率よく供給できるストレージ環境を構築することだ。
現在のAIシステムでは、GPUに搭載されたHBMが重要な役割を担っている。
HBMにはAIモデルの重みだけでなく、推論中の計算結果を保持するKVキャッシュなど、さまざまなデータが保存される。
大規模なモデルを動かしたり、長い文章を処理したり、同時に利用するユーザーを増やしたりすると、限られたHBM容量をどのように使うかが課題になる。
キオクシアの技術解説では、HBMを高速フラッシュストレージで補完する構想が、GPシリーズ開発の背景として紹介されている。
頻繁にアクセスするデータをHBMに置き、それ以外のデータを高速なSSDから必要に応じて読み出せるようにすれば、GPUが利用できるデータ量を増やせる可能性がある。
ただし、ストレージの容量を増やすだけで、GPUの処理性能が向上するわけではない。
どのデータをHBMに置き、どのデータをSSDから読み出すのかによって、実際の性能は大きく変わる。
SSDからの読み出しを待つ時間が長ければ、GPUの計算能力を十分に活用できない可能性もある。
そこで重要になるのが、GPUからストレージへ効率よくアクセスするための仕組みだ。
NVIDIAが推進する「Storage-Next」は、こうした新しいストレージアクセス方式の実現を目指す業界横断の取り組みである。
2026年8月のFMSに関するNVIDIAの発表によると、キオクシアやMicronなど40社以上が参加している。
その中心的な技術の一つが「SCADA」だ。
SCADAは、GPUの並列処理能力を活用し、アプリケーションが必要とするデータをストレージからGPUメモリへ効率よく取り込むためのソフトウェア基盤である。
ここで重要なのは、「GPUメモリへ直接データを転送すること」と、「GPU自身がストレージへの読み出し要求を発行すること」は異なるという点だ。
従来のGPUDirect Storageでは、ストレージからGPUメモリへデータを転送する際、CPUメモリを経由した余分なコピーを省くことができる。
ただし、転送処理の設定などを担うドライバーは、引き続きCPU上で動作する。
これに対し、Storage-Nextが目指すのは、GPU側から小さなデータの読み出し要求を大量に発行できる仕組みだ。
キオクシアのGPシリーズは、こうしたGPU主導の細かなストレージアクセスに対応するため、高いランダム読み出し性能を追求している。
9月30日に公開されたNVIDIAの技術資料では、「SCADA Server SDK」が紹介された。
このSDKは、GPU側のSCADAクライアントから送られる要求に応答するストレージサーバーを開発するためのものだ。
IBMも、SCADAとIBM Storage Scaleを組み合わせた試作システムの動作を実演している。
つまり、キオクシアがSSDのランダム読み出し性能を高める一方で、NVIDIAやストレージ関連企業は、その性能をGPUから活用するためのソフトウェアや通信基盤を整備している。
ただし、GPUから直接ストレージへアクセスする仕組みでも、CPUやOSの役割が完全になくなるわけではない。
SCADAでは、高速なデータ処理を担う部分と、ストレージへのアクセス権限を管理する部分を分離している。
GPUが大量の読み出し要求を発行できるようになっても、許可されていないデータへのアクセスを防ぐ仕組みは必要だ。
なお、キオクシアの今回の発表では、2,000万IOPS超の技術デモにSCADAを使用するかどうかは明らかにされていない。
どのGPUを使い、どのようなソフトウェア構成で性能を測定するのかも公表されていないため、Storage-Next全体の技術開発と、今回のSSDの評価環境は区別して考える必要がある。
2028年には1億IOPSを目指す、製品化に向けた課題
キオクシアは、GPシリーズのさらなる性能向上も計画している。
同社のロードマップ資料では、第3世代XL-FLASHとPCIe 7.0を組み合わせ、2028年に512バイトのランダム読み出しで1億IOPSを目指す構想が示されている。
これは、今回予告された2,000万IOPS超のさらに約5倍に相当する性能だ。
ただし、資料ではこの構想は「検討中」とされており、製品の仕様や出荷時期が正式に確定したわけではない。
また、今回の改良版と2028年を目標とする次世代SSDは、同じ第3世代XL-FLASHを採用する構想であっても、開発段階が異なる。
フラッシュメモリの世代番号が、そのままSSD製品の世代を表すわけでもない。
キオクシアは今回の改良版を「GP2」とは発表しておらず、接続インターフェースについても明らかにしていない。
過去に発表された1億IOPSという数値についても、実際のSSDが達成した性能と混同しないよう注意が必要だ。
キオクシアは2025年のFMSで、将来の高IOPS環境を模擬するエミュレーターを使い、ソフトウェアの開発や検証を進める方法を紹介していた。
その際に示された1億IOPS級の処理性能は、エミュレーターによる結果であり、実際のSSDが同じ性能を達成したことを示すものではない。
2025年のエミュレーターによる検証、今回の2,000万IOPS超の技術デモ、2028年を目指す1億IOPSの構想は、それぞれ異なる段階の成果として捉える必要がある。
また、キオクシアは今回のOCP Global Summitで、大容量SSD「LD4」も展示する予定だ。
LD4の発表によると、第8世代BiCS FLASHのQLC NANDを採用し、読み出し中心の用途を想定した高密度データセンター向けSSDとして開発されている。
15.36TBと30.72TBのサンプルを提供するほか、検証済みのアーキテクチャでは最大122.88TBまで容量を拡張できるとしている。
ただし、122.88TBはアーキテクチャの拡張可能容量であり、今回その容量の製品サンプルを提供するという意味ではない。
GPシリーズとLD4では、重視する性能も異なる。
GPシリーズは、小さなデータを大量に読み出す高IOPS性能を追求する。一方、LD4は大量のデータを保存できる高密度ストレージを目指している。
どちらもAIインフラ向けのSSDだが、用途が異なるため、単純に性能の優劣を比較することはできない。
今後、GPシリーズ改良版を実際のAIシステムに導入できるかを判断するには、さらに詳しい性能データが必要になる。
特に重要なのは、2,000万IOPS超を達成した際の同時読み出し要求数と、個々の要求に対する応答時間だ。
ストレージに大量の要求が集中した場合でも、応答の遅れを抑えられるかどうかが、GPUの稼働率に影響する。
また、読み出しと書き込みが混在する負荷での性能や、SSDの容量、消費電力なども確認する必要がある。
消費電力や発熱量が明らかになれば、データセンターで必要になるSSDの台数や、冷却設備への負担も見積もりやすくなる。
さらに、こうしたハードウェアの性能を活用するためには、SCADAなどの対応ソフトウェアとの組み合わせも重要だ。
今回の2,000万IOPS超という発表は、GPU向けストレージの高速化が進んでいることを示す一方、その性能が実際のAI処理をどれだけ改善するかは、まだ明らかになっていない。
今後、具体的な測定条件や対応ソフトウェアが公開され、実際のAIワークロードでGPUの待ち時間を短縮できることが確認されれば、高速フラッシュメモリをHBMの補完領域として活用する構想は、実用化に向けてさらに前進する。
その段階になって初めて、性能とコストの両面から、従来のメモリ構成に対する優位性を具体的に評価できるようになる。