


IBMは2026年11月11日、次世代の超伝導量子プロセッサ「IBM Quantum Nighthawk r3」の設計目標を発表した。2,034個の物理量子ビットのうち520個をプログラム可能とし、1万回の量子演算を高精度に実行することを目指す。さらに2027年には、2基のNighthawk r3をチップ間インターコネクトで接続し、1,040個のプログラム可能量子ビットを備えたシステムを構築する計画だ。
ただし、今回公表されたNighthawk r3の仕様は、完成したプロセッサの実測性能ではなく、開発上の目標値である。現在クラウド経由で利用でき、サンプリング速度などの実測データが報告されているのは、前世代の「Nighthawk r2」だ。IBMはチップ間接続や極低温冷却システムの実証結果も発表しているが、これらは個別の要素技術に関する成果であり、1,040量子ビットの連結システム全体が動作したことを意味しない。今回の発表を評価するには、既存プロセッサの実績、要素技術の検証結果、将来の設計目標を区別する必要がある。
Nighthawk r3は520量子ビット、1万演算を目指す
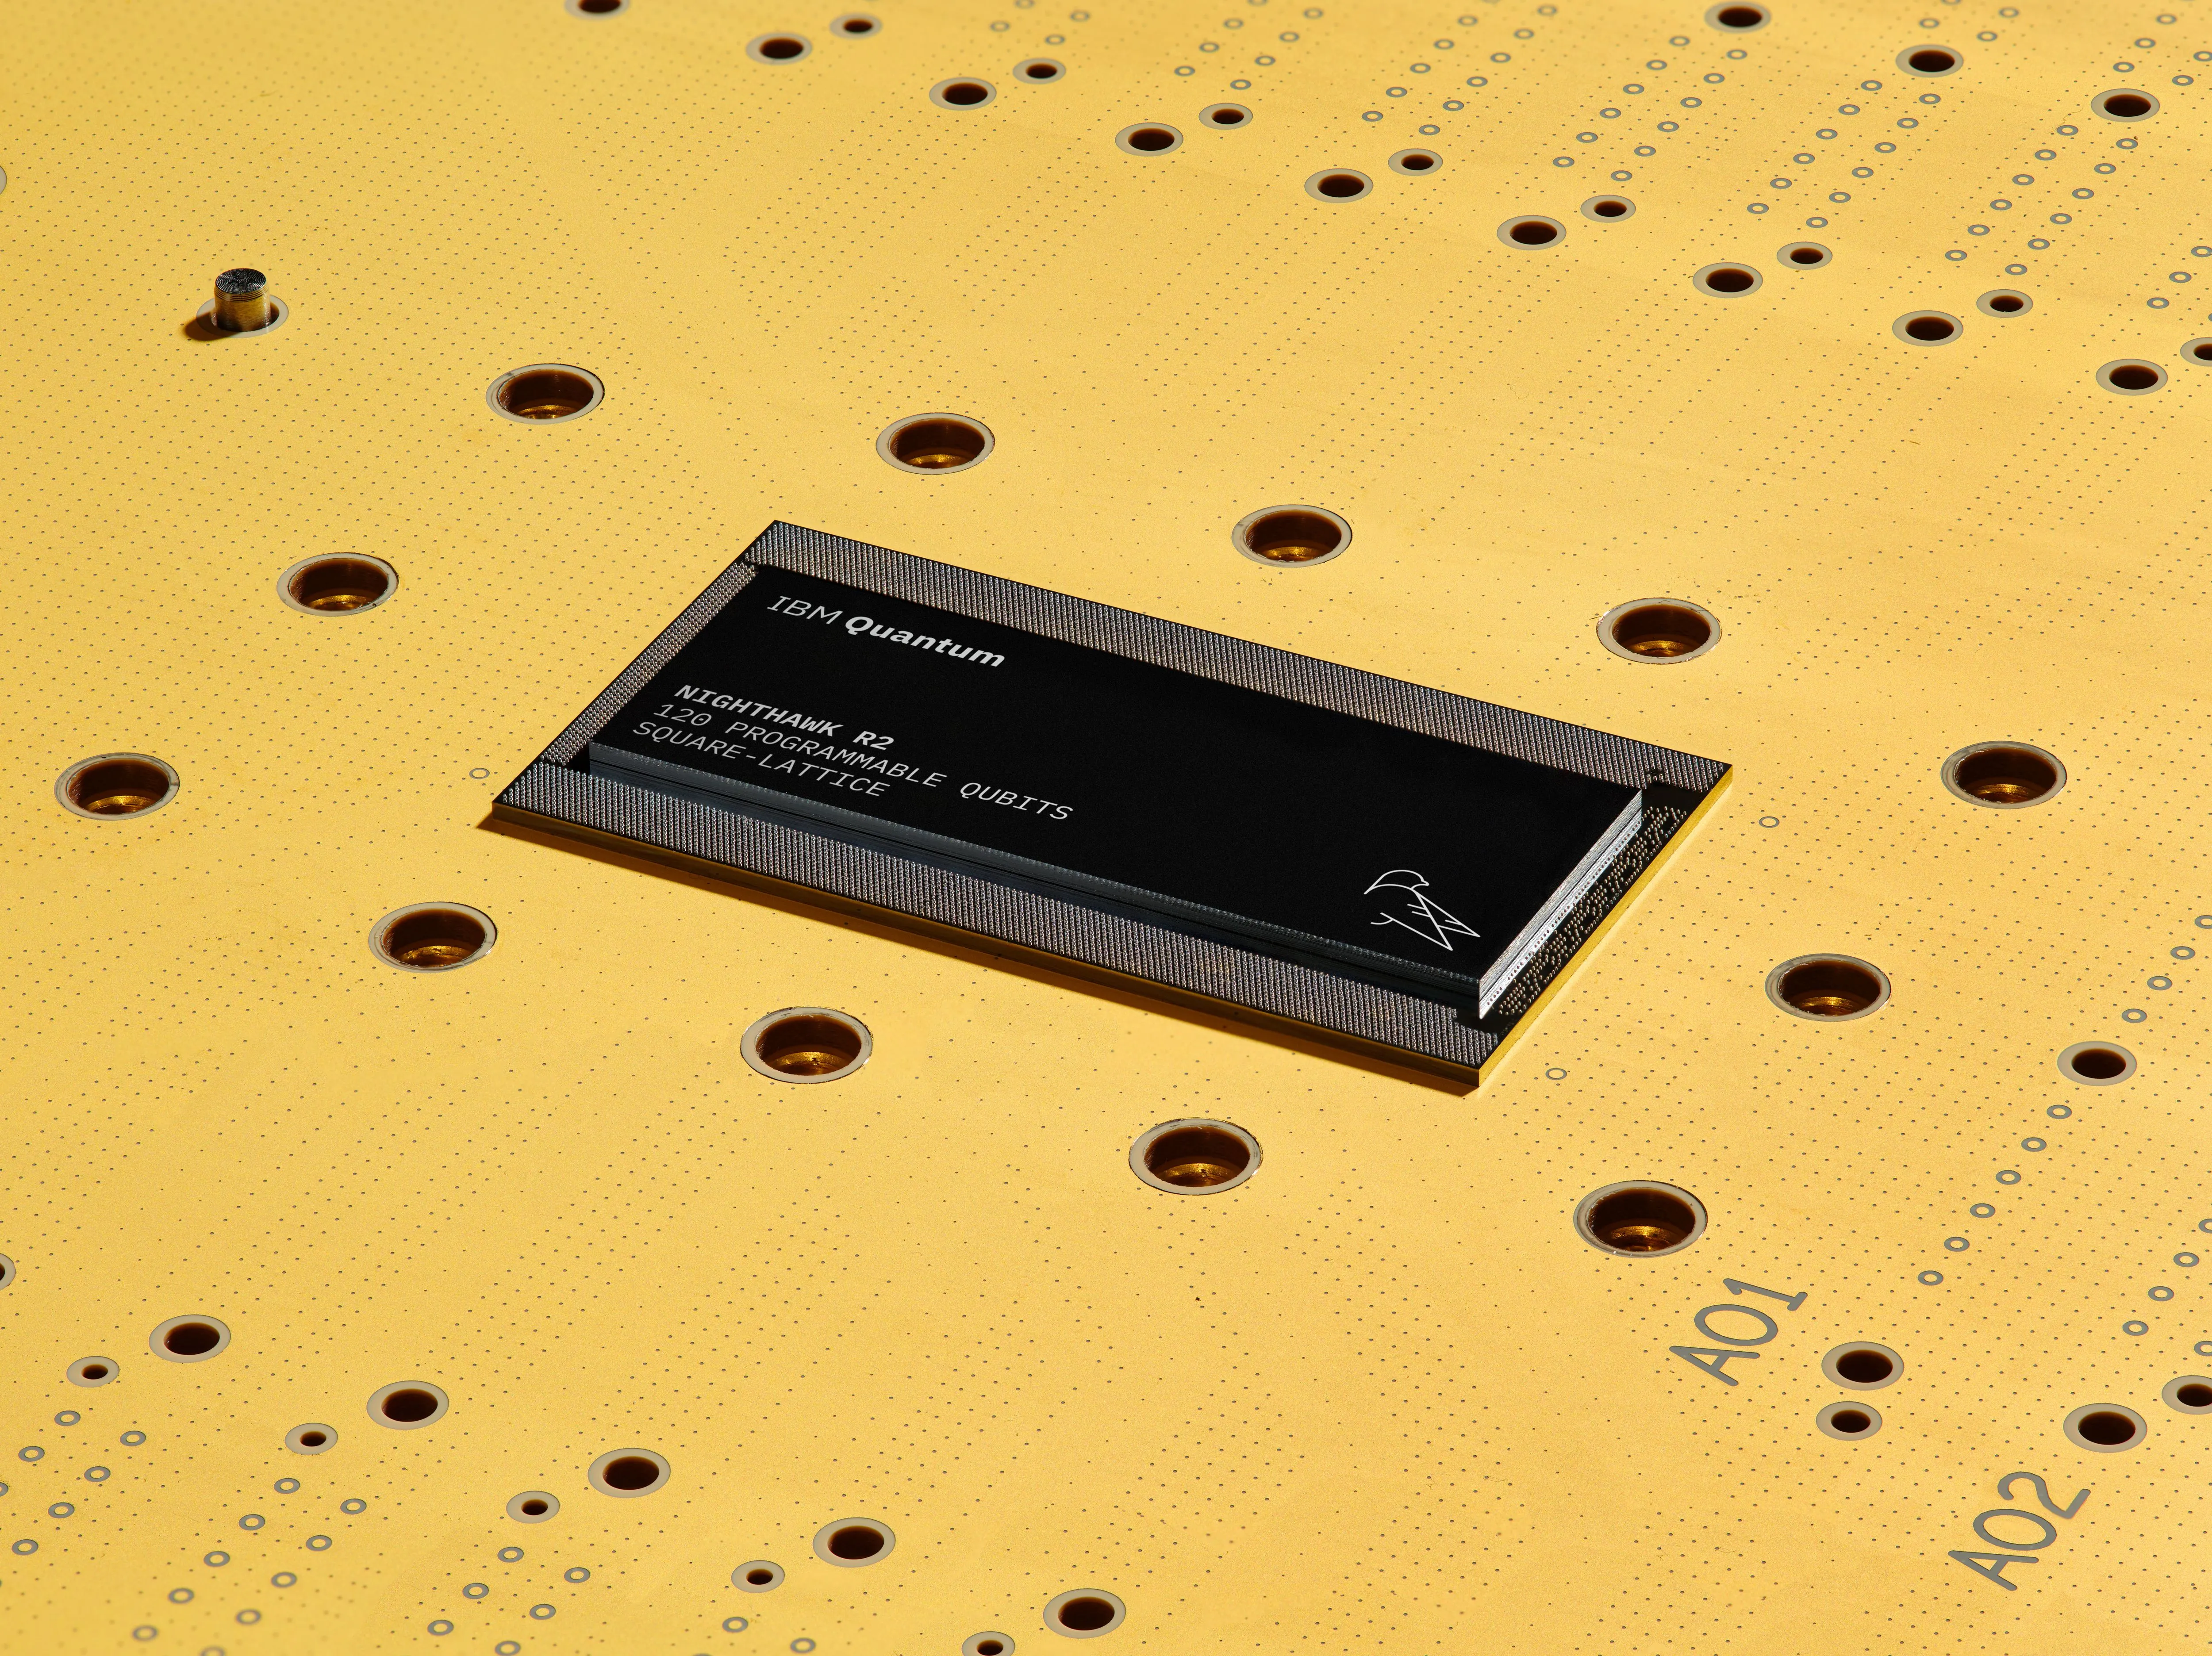
Nighthawk r3についてIBMが示した仕様は、520個のプログラム可能量子ビット、物理量子ビット総数2,034個、そして1万回の量子演算への対応だ。いずれも設計目標であり、現時点で実機によって達成が確認された数値ではない。Baystreetの報道でも指摘されているように、IBMは今回の発表でNighthawk r3の具体的な投入時期を明らかにしていない。
一方、2026年9月に導入されたNighthawk r2は、すでに稼働実績を積んでいる。r2は120個のプログラム可能量子ビットを備え、物理量子ビットの総数は458個だ。IBMによると、7,500回以上の量子演算を高精度に処理でき、毎秒最大10万サンプルの取得に対応するという。
量子コンピュータの性能を比較する際には、量子演算の回数とサンプリング速度を区別する必要がある。回路内で実行する量子演算の数は計算規模や複雑さに関係する一方、サンプリング速度は、同じ量子回路を繰り返し実行して測定結果を取得する処理能力を表す。通常、1回の量子回路実行で得られるのは1つの測定結果であり、確率分布を十分な精度で推定するには、問題に応じて数百万回から数十億回もの測定が必要になる。大規模な量子回路を実行できても測定に膨大な時間がかかれば実用性は限られるが、サンプリング速度が高いだけでも計算精度や古典コンピュータに対する優位性は保証されない。
| システム | 開発・提供状況 | プログラム可能量子ビット | 物理量子ビット総数 | 量子演算の規模 | 主な性能・機能 |
|---|---|---|---|---|---|
| Nighthawk r2 | 提供中・実測データあり | 120 | 458 | 7,500回以上に対応 | 毎秒最大10万サンプル、高速量子ビットリセット |
| Nighthawk r3 | 設計目標を公表 | 520 | 2,034 | 1万回を目標 | 正方格子結合、10系統のl-coupler |
| Nighthawk r3連結システム | 2027年の構築計画 | 1,040 | システム全体の仕様は未公表(2基の単純合計は4,068) | 未公表 | 2基をl-couplerで接続、モジュール型冷凍機を統合 |
Nighthawk r2で最大25倍のスループット向上を報告
現行のNighthawk r2では、量子回路の実行間隔を短縮する高速量子ビットリセット技術が採用されている。IBMの技術解説によると、この技術によって従来の「IBM Quantum Heron」と比較して最大25倍のスループット向上を達成し、毎秒最大10万サンプルの取得が可能になった。ただし、確認できた公表資料には、比較対象となるHeronのスループットの絶対値は示されていない。
IBMによれば、エネルギー企業のE.ON、量子計算ソフトウェア企業のAlgorithmiq、Q-CTRLなどの顧客・パートナー企業は、Nighthawk r2で累計340億回以上の量子回路実行を行った。これらの取り組みでは、過去のIBM製プロセッサと比較して最大19倍の性能向上が報告されている。ただし、この数字は特定のワークロードで得られた最大値であり、すべての量子アルゴリズムが同じ倍率で高速化するわけではない。比較対象となった旧プロセッサとr2についても、確認できた資料では実行時間やスループットの絶対値が示されていない。
個別の成果として、E.ONは電力網の最適化に向けた量子機械学習タスクで、Heronを使用した場合と比較して15倍の高速化を報告した。また、IBMとオークリッジ国立研究所(ORNL)の共同研究では、磁性材料のシミュレーションで中性子散乱実験と一致する結果を得るとともに、Heron比で12倍の高速化を達成したとしている。
データを表で見る
| Heron比の報告値 (倍) | |
|---|---|
| 電力網最適化(E.ON) | 15 |
| 磁性材料計算(IBM/ORNL) | 12 |
| 材料ダイナミクス(Algorithmiq) | 8 |
フィンランドのAlgorithmiqとの共同研究でも、不均一量子材料のダイナミクスをシミュレーションする回路をHeron比で8倍高速に処理したと報告されている。こうした事例は、Nighthawk r2が実際の研究用途で処理時間の短縮に貢献していることを示す。ただし、各事例の比較条件や実行時間の絶対値が十分に示されていないため、異なるワークロード間で高速化倍率を単純に比較することはできない。
IBMはさらに、Nighthawk r2が採用する正方格子状の量子ビット結合構造について、古典コンピュータによるシミュレーションの難しさを評価した。IBMの試算では、同じ精度を維持しながら主要なテンソルネットワーク法で拡張回路をシミュレーションする場合、従来のヘビーヘックス(heavy-hex)格子を使った実装と比べて、約240倍のメモリ容量が必要になるという。ただし、比較対象となるメモリ容量の絶対値は示されていない。
この240倍という数値は、特定のテンソルネットワーク手法を用いた場合の推計であり、実測された処理速度の差ではない。また、古典コンピュータには別のアルゴリズムや近似手法も存在するため、この結果だけで古典計算による再現が不可能になったとは言えない。正方格子構造によって量子回路のシミュレーションが難しくなる可能性は示されたものの、古典コンピュータに対する量子優位性が確立されたわけではない。
チップ間接続「l-coupler」で1,040量子ビットへ拡張
Nighthawk r3の設計で重要な役割を担うのが、複数の量子プロセッサを接続する「l-coupler」と呼ばれるチップ間インターコネクトだ。IBMはNighthawk r3に10系統のl-couplerを搭載し、正方格子状の量子ビット結合構造を維持しながら、複数のチップを連動させる設計を採用する。2027年には2基を接続し、合計1,040個のプログラム可能量子ビットを備えたシステムを構築する計画である。
量子プロセッサを大型化するには、単一チップに搭載する量子ビット数を増やす方法がある。しかし、チップ面積の拡大には製造歩留まりの低下や配線の複雑化といった課題が伴う。複数の比較的小さなチップを接続するモジュール方式は、こうした制約を緩和しながらシステム全体の量子ビット数を増やす手段となる。IBMは今回、この方式の実現に必要なチップ間接続と冷却システムについて、それぞれ実証結果を発表した。
チップ間接続については、初期型のNighthawk r1プロセッサ2基を4本のl-couplerで接続する実験を実施した。IBMによると、チップ間の量子状態転送忠実度は平均99%、最高99.3%に達した。同社は将来的に99.9%の忠実度を目指しており、今回の実験で一定の成果を得たものの、目標にはまだ届いていない。
ただし、99.3%という数値が示すのは、チップ間で量子状態を転送する際の特定の接続部における忠実度であり、1,040量子ビットのシステム全体で複雑なアルゴリズムを実行した際の精度ではない。大規模な量子回路では、チップ内の量子ゲート操作に加え、チップ間をまたぐ演算も繰り返される。それぞれの操作に伴う誤差が蓄積するため、個々の接続部で高い忠実度を達成しても、回路全体を十分な精度で実行できるとは限らない。今後は、複数チップにまたがる量子演算の忠実度を実際の回路で評価する必要がある。
もう一つの成果は、極低温冷却システムのモジュール化だ。超伝導量子ビットを動作させるには、絶対零度に近い極低温環境が必要となる。IBMは今回、2基の極低温冷凍モジュールを物理的に接続し、一つの冷却システムとして動作させることに初めて成功したと発表した。このシステムは5日未満で動作温度に到達し、15ミリケルビン(約マイナス273.135度)未満の温度を維持できたという。
これらの実験は、量子プロセッサのモジュール化に必要な接続技術と冷却インフラの両面で進展があったことを示している。ただし、実証されたのは個別の要素技術であり、2基のNighthawk r3を接続した完成システムの動作ではない。2027年の計画を実現するには、接続部の忠実度をさらに高めるとともに、複数チップを使った大規模な量子回路を安定して実行できることを確認しなければならない。
富岳とのハイブリッド計算で進む実証研究
IBMは量子プロセッサの開発と並行して、古典コンピュータと量子コンピュータを組み合わせるハイブリッド計算にも取り組んでいる。量子コンピュータを実際の科学計算に利用するには、量子回路の実行だけでなく、ノイズの解析や誤差の低減、測定結果の後処理などに大量の古典計算資源が必要となる。IBM Quantum Platformを活用した共同研究では、スーパーコンピュータと量子プロセッサを連携させることで、従来より大規模な問題への適用が試みられている。
その一つが、理化学研究所(理研)との共同研究によるサンプルベース量子対角化法(Sample-based Quantum Diagonalization:SQD)だ。2025年に査読付き学術誌『Science Advances』に掲載された論文(Science Advances 11, eadu9991、DOI: 10.1126/sciadv.adu9991)では、IBMの量子プロセッサHeronと理研のスーパーコンピュータ「富岳」を組み合わせ、窒素分子()や鉄硫黄クラスターの基底状態エネルギーを計算した。最大77量子ビット、10,570ゲートの量子回路を使用し、基底状態エネルギーの上限値を求めている。
この研究では、厳密対角化法で直接扱うことが難しい規模の問題に取り組んだ。ただし、「厳密対角化の限界を超えた」という成果は、従来の厳密対角化法では扱いにくい次元数の有効空間を対象にしたという意味であり、すべての古典計算手法を上回ったことを示すものではない。実際に得られたのも、基底状態エネルギーの上限値や波動関数の疎な近似であり、古典コンピュータによる近似計算との比較は引き続き必要となる。
SQDを発展させたクローズドループ電子状態計算の研究も進められている。プレプリントサーバーarXivに公開された論文(arXiv:2511.00224)では、誤り耐性を備えていないHeronプロセッサと、最大152,064ノードの富岳を組み合わせ、77量子ビットを使った計算を実施した。エネルギー分散外挿によって補正した後の計算誤差は、古典計算の代表的な高精度手法である密度行列繰り込み群(DMRG)法による結果に対して約0.1ハートリーだった。
化学計算で一般的な精度の目安とされる約0.0016ハートリーと比較すると、今回報告された誤差にはまだ大きな開きがある。大規模なスーパーコンピュータによる後処理を組み合わせても、十分な計算精度を確保することは容易ではない。量子プロセッサを使ってより大規模な問題に取り組めるようになった一方、古典計算に対する精度や計算効率の優位性については、さらなる検証が求められる。
医療・創薬分野への応用も研究されている。クリーブランドクリニックや理研との共同研究によるタンパク質とリガンドの結合モデリングについては、2026年5月にプレプリント(arXiv:2605.01138)が公開された。この研究では、156量子ビットのHeron r2プロセッサ2基を使用し、最大94量子ビットを用いた21,006種類の回路を実行した。30億回の測定結果を取得するまでに239時間以上を要したと報告されている。
さらに、自動化された計算パイプラインによって、6億800万サンプルを62.4時間で処理したという。この成果は、量子計算を組み込んだ大規模な計算化学ワークフローの自動化が進んでいることを示している。一方、測定や後処理には依然として長い時間が必要であり、処理効率の改善は重要な課題として残る。また、この研究は分子の結合を計算する技術の実証であり、新薬の臨床的有効性や実際の治療効果を確認したものではない。
これらの研究に共通するのは、量子プロセッサだけで計算を完結させるのではなく、スーパーコンピュータの計算能力を積極的に利用している点だ。量子回路から得られた測定データを古典計算で処理し、誤差の影響を抑えながら解を求める手法は、現在の量子コンピュータを科学計算に活用するための重要な選択肢となっている。ただし、古典計算資源への依存が大きい以上、量子プロセッサ部分の高速化だけでなく、システム全体の計算時間や精度、必要な計算資源を評価することが欠かせない。
2029年の誤り耐性量子コンピュータ実現に向けた課題
今回のIBMの発表では、実証済みの成果と今後の開発目標を分けて評価する必要がある。Nighthawk r2については、毎秒最大10万サンプルの取得能力や、特定のワークロードでの処理時間短縮が報告されている。また、チップ間接続では量子状態転送忠実度99.3%という実験結果が得られ、極低温冷却システムのモジュール化にも成功した。一方、Nighthawk r3の520量子ビットと1万回の量子演算、2027年の1,040量子ビットシステムは、いずれも今後の開発目標だ。
現時点で確認できる公表資料には、Nighthawk r3の設計目標を第三者が検証するための共通データセットや、量子ゲートのエラー率の詳細、測定値の統計的な不確実性などは含まれていない。2基のNighthawk r3を接続し、システム全体で量子回路を実行した結果もまだ示されていない。Nighthawk r2で報告された累計340億回以上の回路実行、最大19倍の性能向上、古典シミュレーションに必要なメモリ容量が240倍になるという試算も、IBMや共同研究企業の公表内容に基づいている。独立した第三者による再現実験や、統一条件でのベンチマークによって検証された標準的な性能値ではない点に注意が必要だ。
また、特定の量子回路で高速化を達成しても、古典コンピュータより短時間かつ低コストで問題を解けるとは限らない。実用的な計算性能を評価するには、量子回路の実行時間に加え、測定回数、誤差低減処理、古典計算による後処理、必要な計算資源や消費電力まで含める必要がある。古典側でもアルゴリズムやGPUクラスタによるシミュレーション技術の改良が続いており、量子コンピュータの優位性を評価するための比較対象も変化している。
IBMが公開しているロードマップでは、2029年に誤り耐性量子コンピュータ「Starling」を実現することが目標となっている。Starlingは量子誤り訂正を利用し、1億回規模の量子演算を実行する構想だ。一方、今回発表されたNighthawk r3と2027年の連結システムは、量子誤り訂正による本格的な誤り耐性を備える前の段階に位置づけられる。したがって、量子ビット数や実行可能な演算回数の増加だけで、Starlingが目指す誤り耐性を達成できるわけではない。
Nighthawk r3の重要性は、単一チップの性能向上にとどまらず、複数の量子プロセッサを接続して計算規模を拡張する設計を具体化したことにある。チップ間接続と冷却システムの実証は、その実現に向けた進展といえる。ただし、520量子ビットで1万回の量子演算を実行する設計目標が実機で達成されるか、さらに2基を接続しても十分な計算精度を維持できるかは、これから検証される課題だ。今後はNighthawk r3の投入時期に加え、チップ間をまたぐ量子ゲートのエラー率、大規模回路全体の実行忠実度、古典スーパーコンピュータとのハイブリッド計算で得られる実質的な性能向上が、IBMの拡張戦略を評価する重要な指標となる。


