

サイエンス
映像の質量と速度から完璧な音を作り出す次世代AIモデルをKAISTとSony AIが開発
映像の「見た目」だけで音を作る時代は終わった。KAISTとSony AIが共同開発した新技術『PAVAS』は、映像から物体の「質量」と「速度」を力学的に推定し、現実の物理法則に忠実なリアルな音響を生成する。映画やゲーム体験を変革する「Physical AI」の最前線に迫る。

Topic
Generative AI
全 2,432 件 / 203 ページ
映像の「見た目」だけで音を作る時代は終わった。KAISTとSony AIが共同開発した新技術『PAVAS』は、映像から物体の「質量」と「速度」を力学的に推定し、現実の物理法則に忠実なリアルな音響を生成する。映画やゲーム体験を変革する「Physical AI」の最前線に迫る。
中国の公共空間で何百万台ものカメラが稼働していることは広く知られているが、そのカメラに何ができて何ができないかは、思われているより単純ではない。長年にわたって構築された監視網は実のところ「反応型」のシステムだった。すでにウォッチリストに載っている人物が画角に入れば警報を鳴らせるが、それ以外の人物の行動を事前に解析する能力は乏しかった。その前提が今、変わろうとしている。HikvisionとHuaweiのAIカメラ・ソフトウェアによって、中国各地の地方政府は既存の監視インフラを刷新しており、テキストを打ち込むだけで映像を横断検索できる新世代のシステムが現実の運用に入りつつある。

Sam Altman氏らがAI雇用崩壊論を修正した背景を、労働統計や企業導入の遅さから整理。短期の大規模失職は見えない一方、若手職や仕事の中身に残るリスクを読み解く。
FuriosaAIとBroadcomが第3世代AI推論チップを共同開発。2nm演算ダイとHBM4/4E、Ethernet基盤でラック規模の推論効率を狙う。

AlibabaのXuanTieチームは、RISC-VベースのプロセッサでAndroid 16の動作に成功し、ARM独占状態だったモバイル市場にRISC-Vが実用的な選択肢となることを示した。これは、RVA23標準準拠プロセッサでの最新Android稼働の初事例であり、互換性確保や開発環境整備、セキュリティ要件適合を通じて、RISC-Vが商用レベルの信頼性を獲得したことを意味する。

欧州委員会はGoogleに対し、自社サービスを優遇するDMA違反で数億ユーロ規模の罰金を科す方針を固めた。これはDMA施行以来最高額となる可能性があり、迅速な執行を示す一方、米テック企業への不公正な標的化との批判や外交摩擦の懸念も浮上している。

AIの安全性と中立性を評価するCEFE-AIの研究チームは、AIが特定の価値観を「言わない」ことによる「不作為のバイアス」を指摘した。彼らのベンチマークテストにより、人間が倫理的問いに宗教的視点を期待するにもかかわらず、AIは実践的な助言の場面で宗教的リソースをほとんど提示しないことが明らかになった。AIは抽象的な存在論的質問には宗教に言及するが、人間の深い絶望には世俗的な解決策のみを提供し、宗教を生活の知恵から切り離している。
AIデータセンターのGPUやAIアクセラレータは、高密度な電力消費による「熱」がボトルネックとなり性能が制限されている。これに対しSK hynixは、HBMパッケージ内部に直接冷却要素を埋め込む「iHBM」を発表し、熱源から直接冷却することで熱抵抗を30%削減、高負荷時でも安定した性能維持を可能にした。この技術は、次世代AIハードウェアの設計を根本から変える画期的なブレイクスルーである。
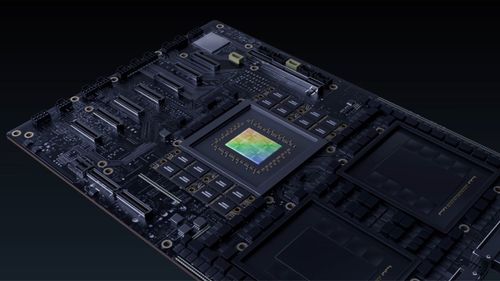
NVIDIAの次世代データセンター向けCPU「Vera」が、従来の「効率のArm、絶対性能のx86」というCPUアーキテクチャの棲み分けを覆し、x86のフラッグシップモデルを演算性能で凌駕した。Veraは、自社設計のカスタムコア「Olympus」とモノリシックダイ、そして超広帯域メモリ「LPDDR5X」を採用することで、エージェント型AIの処理に不可欠な強力で応答性の高いCPUを実現し、ベンチマークテストでx86プロセッサを大きく上回る性能を示した。
フリンダース大学とハリファ大学の共同研究チームは、次世代半導体材料の探索におけるボトルネックを打破するため、ベイズ最適化を用いた「スマート材料発見エンジン」を開発した。このエンジンは、膨大な化学空間からガリウムベースの新規半導体を効率的に逆設計し、特定のバンドギャップを持つ材料を高速で特定可能であり、材料科学に新たなパラダイムをもたらす。
AMDの次々世代CPU「Zen 7」の詳細情報が異例の早さで流出し、2028年にTSMC A14プロセス、最大16コア、刷新されたキャッシュ設計、新パッケージング技術FOPLPを採用し、AIサーバー需要に対応する大規模な技術転換を計画していることが明らかになった。これはN2P・A16といった中間ノードをスキップし、A14に直行することで、AIワークロードに求められる性能と電力効率を大幅に向上させる狙いがある。 Zen 7は、L2キャッシュの倍増やL3キャッシュの133%増に加え、AVX10やACEなどの命令セット拡張によりAI推論性能を強化する。さらに、従来のウェハーではなくパネル単位でパッケージングを行うFOPLP技術の採用を検討しており、AI向けGPUに集中するTSMC CoWoSの供給リスクを回避し、コスト削減と供給安定化を図る戦略が伺える。

AutoTTSは、LLMの推論コストを削減するため、制御アルゴリズムの探索自体をAIに委ねるという発想で開発された。Claude Codeを探索エージェントとして活用し、わずか39.90ドルでトークン使用量を約70%削減するアルゴリズムを自律発見した。この低コストは、AIによるアルゴリズム発見が個人研究者やスタートアップにも開かれつつあることを示している。